
4 Kasım 2026 itibarıyla durum
Yazının çıkış noktası olan Flanders ve arkadaşlarının çalışması, 26 Ekim 2026'da medRxiv'de yayımlanmış, hakemden geçmemiş bir ön baskıdır (preprint). Kontrol tarihinde hakemli dergi sürümü ya da düzeltmesi yoktu, bu yüzden sayılar değişebilir. Gönderim günü hedef derginin yazar yönergesi, bu yazıdaki aktarımların hepsinden önce gelir.
Tıp dergilerinde yayımlanan özetlerin ne kadarı yapay zekâ ile üretilmiş metin izi taşıyor? 26 Ekim 2026'da medRxiv'de yayımlanan bir ön baskı, 12 genel tıp dergisinin 15.268 özetini GPTZero adlı yapay zekâ dedektöründen (tespit aracı) geçirerek bu soruyu dergi dergi yanıtlamaya çalışıyor. Ön baskıya göre iz 2022'den sonra arttı, ama artışın zamanı ve büyüklüğü dergiden dergiye çok farklı. 1 Ocak–8 Ağustos 2026 döneminde dedektörün işaretlediği özetlerin oranı New England Journal of Medicine'de (NEJM) %5,7, Frontiers in Medicine'de %83,5; örneklenen dergilerin yayın hacmine göre ağırlıklandırılmış kestirimi %66,7.
Bu sayılar bir dergideki özetlerin ne kadarının dedektöre takıldığını toplu olarak gösteriyor; sizin makalenize çıkan bir dedektör skorunun ne anlama geldiğini söylemiyor. İkisini ayırmak için eşiğe, yanlış pozitif (false positive) oranına ve güven aralığına bakmak gerekiyor.
Ön baskı neyi ölçtü?
Flanders ve arkadaşları, 1 Ocak 2020–8 Ağustos 2026 arasında yayımlanan makalelerden her dergi ve yıl için en fazla 200 özeti rastgele seçti. Başlık ve yazar bilgisi değerlendirilen metne alınmadı; GPTZero her özete sürekli bir "insan yazarlığı" skoru verdi.
Örneklemdeki dergiler BMJ, JAMA, The Lancet, NEJM, BMJ Open, JAMA Network Open, Lancet Regional Health – Europe, European Journal of Internal Medicine, Frontiers in Medicine, Cureus, Journal of Clinical Medicine ve Medicine (Baltimore). Hedef dergi listenizde bunlardan biri varsa çalışma sizi de ilgilendiriyor. Ancak ön baskının ana metninde dergiye özgü 2026 değeri yalnız NEJM ve Frontiers in Medicine için veriliyor. Öteki on derginin değerleri ise şekillerde yer alıyor; bu yazıda o dergiler için oran vermiyoruz.
Ölçülen metin yalnız özet. Yazarlara göre yöntemleri sınırlı bir yapay zekâ yardımını tümüyle yapay zekâ ile üretilmiş metinden bilerek ayırmıyor; yapay zekâ işaretinin yazarın hazırlığından mı yoksa derginin editoryal işlemlerinden mi geldiğini de ayırt etmiyor. Özette iz bulunması tam metinde de yapay zekâ kullanıldığını zorunlu olarak göstermez, ama yazarlara göre ikisi toplu analizlerde güçlü biçimde ilişkili görünüyor. Doğru ifade bu yüzden "yapay zekâ ile yazılmış özet" değil, "dedektörün yapay zekâ işareti verdiği özet"tir.
Dergiye özgü eşik nasıl kuruldu?
Çalışmada GPTZero'dan alınan sonuç "yapay zekâ" ya da "insan" etiketi değil, sürekli bir skor. Skoru karara çevirmek için eşik gerekiyor ve yazarlar eşiği her dergi için o derginin kendi verisinden belirledi. Eşik, derginin 2020–2021 özetlerinin %1'ini işaretleyecek değere ayarlandı; skoru bu eşiğin altında kalan özet pozitif sayıldı.
2020–2021, ChatGPT'nin Kasım 2022'de geniş kullanıma açılmasından önceki dönem ve yazarlar bu yılları yapay zekâ öncesi taban olarak aldı. Tabandaki özetler insan yazısı kabul edildiğinde eşiğin altında kalan %1 tanım gereği yanlış pozitiftir. Yani dedektörün yanlış pozitif oranı ölçülmedi, her dergi için %1'e sabitlendi.
Yazarlara göre dergiye özgü kalibrasyon, dergiler arasındaki kalıcı üslup farklarından gelen karıştırıcı etkiyi azaltıyor. Bu tercih, aynı skorun her dergide aynı anlama gelmediği kabulüne dayanıyor. Tek bir makaleye bakan editörün ya da kendi metnini dedektörden geçiren yazarın elinde böyle bir kalibrasyon yok; o metnin skoru bu oranlarla karşılaştırılamaz.
Eşik yanlış pozitifi denetler, duyarlılığı denetlemez. Dedektörün 2026'da izli özetlerin ne kadarını yakaladığı bu tasarımda bilinmiyor. Yazarlara göre tespit yöntemleri üretken yapay zekâ araçlarının gerisinde kalıyor ve son dönemdeki yaygınlık büyük olasılıkla düşük kestirildi. Eşik sabitken insan yazısı da değişebilir; yazarların kabul ettiği gibi makale karışımı, yazarlık ya da editoryal uygulamadaki değişiklikler de eğilime katkıda bulunabilir.
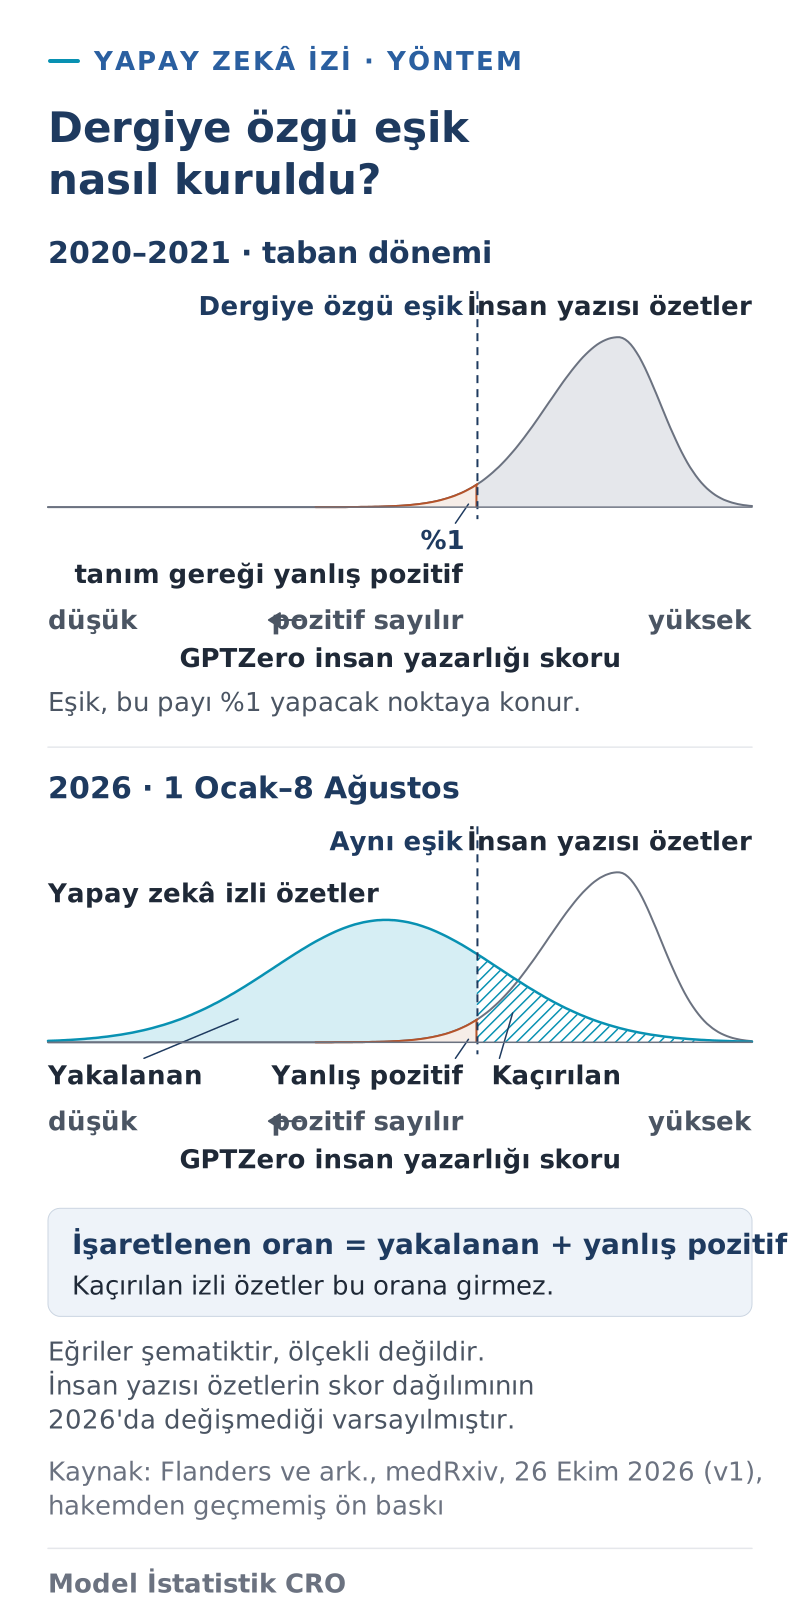
Şeklin üst paneli 2020–2021 taban dönemini gösteriyor. İnsan yazısı özetlerin skor eğrisinde eşiğin solunda kalan ince kuyruk, tanım gereği yanlış pozitif sayılan %1'lik pay. Alt panelde aynı eşik 1 Ocak–8 Ağustos 2026 dönemine uygulanıyor. Eşiğin solunda yakalanan izli özetlerle yanlış pozitifler, sağında kaçırılan izli özetler duruyor. Eğriler şematik ve ölçeksiz; şekil, insan yazısı özetlerin skor dağılımının 2026'da değişmediğini varsayıyor.
İşaretlenen oran gerçek yaygınlıkla aynı şey mi?
Değil; tarama testlerindeki görünen yaygınlık ile gerçek yaygınlık ayrımı burada da geçerli. İşaretlenen oranda, gerçekten iz taşıyıp yakalanan özetlerle insan yazısı olduğu hâlde eşiğin altına düşen özetler bir arada bulunur. İz taşıyıp yakalanamayanlar ise orana hiç girmez. Ön baskının sayıları bu toplamdır; ana metinde tabandaki %1'lik payın kestirimden çıkarıldığına dair bir adım yok.
Yanlış pozitif oranı 2026'da da %1 dolayında kaldıysa bu payın ağırlığı oran büyüdükçe azalır. Frontiers in Medicine'in %83,5'i yanında %1 belirgin bir fark yaratmaz. NEJM'de ise %5,7'lik kestirimin %95 güven aralığının alt sınırı %2,1 ve bu değer tabanda tanım gereği işaretlenen %1'den çok uzak değil. Yazarların vermediği "düzeltilmiş" bir sayı üretmek doğru olmaz; ama düşük oranlı bir dergide işaretlenen özetlerin bir kısmının yanlış pozitif olabileceğini hesaba katmak gerekir.
Güven aralıkları 1.000 tekrarlı bootstrap yeniden örneklemesiyle hesaplandı. Yazarlar yeniden örneklemenin birimini ana metinde belirtmiyor. Eşikler bu hesapta sabit tutulduğu için güven aralığı, eşiğin 2020–2021 örnekleminden kestirilmesinden doğan belirsizliği içermez; dedektörün 2026 metinlerinde ne kadar isabetli olduğuna dair belirsizlik de aralığa girmez. Sistematik bir sınıflama hatası aralığı genişletmez, kestirimi kaydırır.
Yazarlar taban yanlış pozitif oranını %1 ile %4 arasında değiştirdiğinde hacim ağırlıklı 2026 kestirimi %66,7 ile %73,9 arasında kaldı. Ön baskının özetinde eğilimlerin, bulgular bölümünde ise kestirimlerin bu seçime "duyarsız" olduğu yazıyor; bulgulardaki yargı da tam bu aralığa dayanıyor. Yine de oranın düzeyi eşik seçimine göre değişiyor; %66,7'yi okurken bu aralığı akılda tutmak gerekir.
%66,7 tıp literatürünün tamamına ait bir oran değil, örneklenen 12 derginin yayın hacmine göre ağırlıklandırılmış kestirimi. Böyle bir ortalamayı çok makale yayımlayan dergiler daha çok belirler. Yazarlar ağırlık formülünü ana metinde vermiyor. Yöntemde geçen tek hacim değişkeni dergilerin 2025'in tamamında PubMed'de dizinlenen makale sayısı; bu değişken dergi düzeyindeki ilişki analizi için tanımlanıyor, ağırlık olarak kullanıldığı yazmıyor. "Tıp makalelerinin üçte ikisini yapay zekâ yazıyor" cümlesi bu çalışmadan çıkmaz.
İşaretlenen oran etki faktörü yüksek dergilerde daha düşük, tamamen açık erişimli dergilerde daha yüksek bulundu. Yazarlar 12 dergiye dayanan bu karşılaştırmanın betimsel okunmasını istiyor; metinde hangi derginin hangi yayın modelinde sınıflandığı da yer almıyor. Bu ilişkiden ne tek bir makale ne de bir dergi hakkında hüküm çıkar.
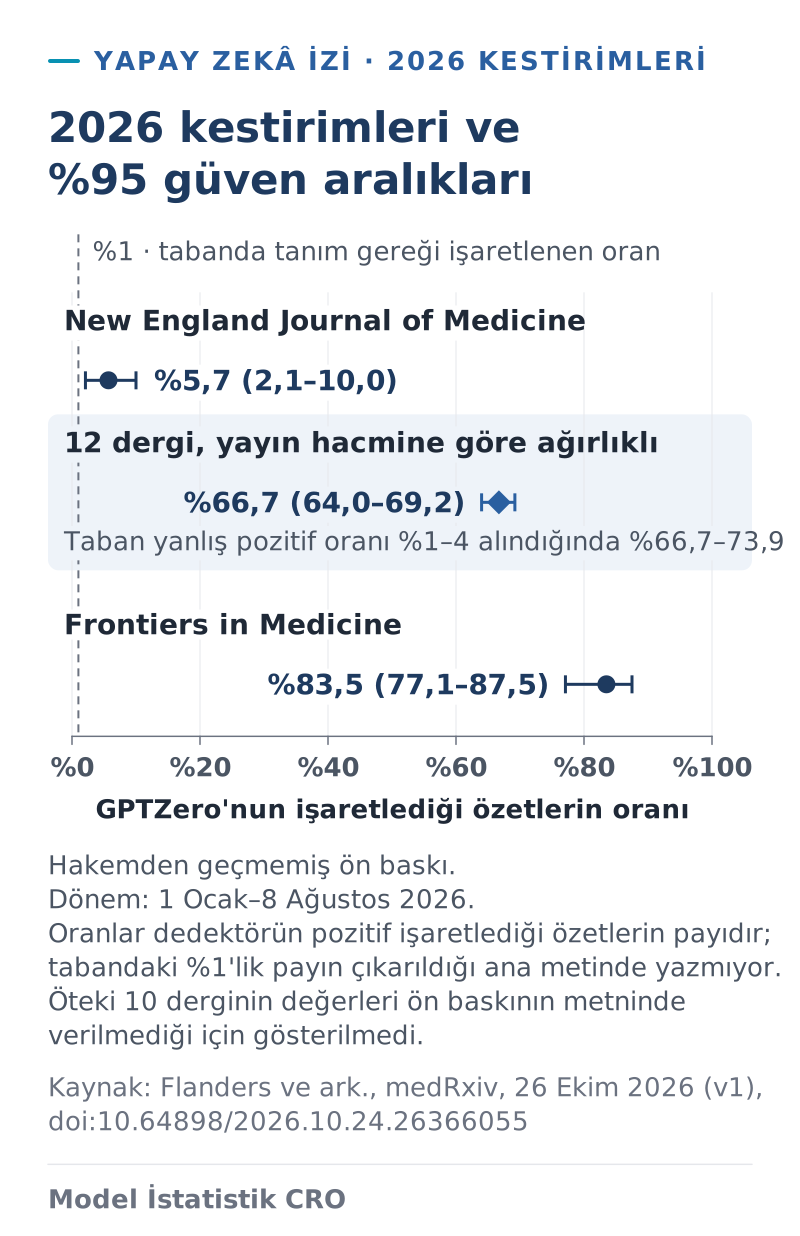
Şekilde işaretlenen oran NEJM için %5,7 (%95 güven aralığı 2,1–10,0), örneklenen 12 derginin yayın hacmine göre ağırlıklandırılmış kestirimi için %66,7 (64,0–69,2), Frontiers in Medicine için %83,5 (77,1–87,5). Kesikli dikey çizgi, tabanda tanım gereği işaretlenen %1'lik düzeyi gösteriyor. Taban yanlış pozitif oranı %1 ile %4 arasında alındığında ağırlıklı kestirim %66,7 ile %73,9 arasında kalıyor.
Dedektörler insan yazısını ne sıklıkla yanlış işaretliyor?
Yanıt araca, sürüme, metin türüne ve eşiğe göre değişiyor.
| Çalışma | Sınanan metin | İnsan yazısında bulunan |
|---|---|---|
| Liang ve ark., 2023 | 7 dedektör; 91 TOEFL denemesi ve ABD'li 8. sınıf öğrencilerinin 88 denemesi | ABD'li öğrencilerin denemeleri doğru sınıflandı; TOEFL denemelerinde ortalama yanlış pozitif oranı %61,3 |
| Weber-Wulff ve ark., 2023 | Herkese açık 12 araç ve 2 ticari sistem (Turnitin, PlagiarismCheck) | Hiçbir araç %80 doğruluğa ulaşmadı; 14 aracın 6'sı yanlış pozitif üretti |
| Popkov ve Barrett, 2025 | 2016–2018'de yayımlanmış 100 davranış sağlığı ve psikiyatri makalesi, 200 yapay zekâ metni | Ücretsiz dedektörün akademik metinde yapay zekâ üretimi saydığı payın ortancası %27,2 |
| Erol ve ark., 2025 | 250 nöroşirürji makalesinin ve 750 ChatGPT metninin özet ve giriş bölümleri; Corrector, ZeroGPT, GPTZero | %50 üstü skor alan insan makalesi Corrector'da 76 (%30,4), ZeroGPT'de 40 (%16), GPTZero'da yok |
| Villa ve ark., 2026 | 30'u insan yazısı 120 diş hekimliği makalesi | %60 eşikte insan metinlerinde yanlış pozitif yok; Turnitin'in başarımı orta düzeyde kaldı |
İngilizceyi ikinci dil olarak yazanlar için en dikkat çekici bulgu, Liang ve arkadaşlarının 2023'te Patterns dergisinde yayımladığı kısa yazıdan geliyor. Çin'deki bir forumdan alınan TOEFL denemelerinin %97,8'ini en az bir dedektör işaretledi. Yazarlar, dedektörlerin özellikle ana dili İngilizce olmayanların metinleri değerlendirilirken kullanılmasına karşı kesin bir dille uyarıyor. Onlara göre yapay zekâyı yasaklayan dergiler, İngilizcenin ana dil olmadığı ülkelerden gelen araştırmacıları cezalandırabilir. Yine de %61,3, yedi dedektörün 2023'teki sürümleriyle 91 denemede elde edilen ortalamadır; bu sayıyı genellemek doğru olmaz. Turnitin'in Ekim 2023 tarihli blog yazısına göre en az 300 sözcüklük metinlerde ana dili İngilizce olan ve olmayan yazarlar arasındaki yanlış pozitif oranı farkı küçük ve istatistiksel olarak anlamlı bulunmamış. Bu hakemli bir çalışma değil, üreticinin kendi analizi.
Weber-Wulff ve arkadaşlarının "GPT Zero" için verdiği %50, yazarların tanımına göre bir yanlış pozitif (yanlış suçlama) olasılığıdır. Paydasında 54 belgelik test setinin yalnız insan yazısı belgeleri var; kısmen yanlış işaretlenenler de yanlış pozitif sayılıyor. Yani aracın 2023 sürümü küçük bir insan metni kümesinin yaklaşık yarısını tümüyle ya da kısmen yapay zekâ diye işaretledi. Bu sayı, pozitif sonuçların ne kadarının doğru olduğunu söylemez. Pozitif sonucun güvenilirliği yalnız araca değil, sınanan metinlerde yapay zekânın ne kadar yaygın olduğuna da bağlıdır. Kullanımın seyrek olduğu bir metin kümesinde küçük bir yanlış pozitif oranı bile pozitif sonuçların önemli bir kısmının yanlış olmasına yol açabilir. Aynı çalışmaya göre makine çevirisi yanlış pozitifleri artırabiliyor, araçların genel eğilimi de yapay zekâ metnini yakalamaktan çok insan yazısı saymak yönünde; yazarlar sınadıkları sistemlerin akademik ortamlarda kullanılmaması gerektiği sonucuna varıyor.
Türkiye'den bir ekibin Acta Neurochirurgica'daki çalışmasında GPTZero'nun Haziran 2024 sürümü iyi sonuç verdi, ama hiçbir dedektör %100 güvenilirliğe ulaşmadı. Erol ve arkadaşlarına göre dedektörler kesin çözüm değil yardımcı araç sayılmalı ve akademisyenler hakkında olumsuz işlem için tek dayanak olmamalı.
Turnitin ve GPTZero kendi skorları hakkında ne söylüyor?
Turnitin'in yardım sayfasına göre hedef, yapay zekâ yazısı %20'nin üstünde olan belgelerde belge düzeyindeki yanlış pozitif oranını %1'in altında tutmak. Şirketin kendi açıklamasıyla bu, tamamen insan yazısı her 100 belgeden birinin yapay zekâ yazısı diye işaretlenebileceği anlamına geliyor. Şirketin Mayıs 2023 tarihli bir blog yazısında cümle düzeyindeki yanlış pozitif oranı yaklaşık %4 olarak verilmiş. %1 ile %19 arasındaki skorlar, olası yanlış pozitifleri önlemek için sayı yerine yıldızla (*%) gösteriliyor. Yıldız, modelin belgede %20'nin altında yapay zekâ yardımlı metin saptadığını gösterir; "hiç yok" demek değildir.
Turnitin suistimal kararı vermiyor. Şirkete göre sonuç, eğitimcilerin işlem yapması için tek dayanak olmamalı. Araç yapay zekâ metninin bir kısmını kaçırabilir; birkaç yüz sözcüklük kısa belgelerde ise yapay zekâ ile özgün içeriğin karıştığı bir metni tümüyle yapay zekâ üretimi diye işaretleyebilir. Bu uyarılar öğretmenler ve öğrenciler düşünülerek yazılmış. Yapay zekâ skoru benzerlik raporundaki örtüşme oranından da ayrı bir ölçümdür. Benzerlik raporunun nasıl okunacağını intihal önleme yazımızda anlattık.
GPTZero kendi sitesindeki bir yazıda %99 doğruluk ve en fazla %1 yanlış pozitif oranı bildiriyor; aynı yazı %100 garantinin hiçbir zaman olmayacağını da kabul ediyor. Liang ve arkadaşlarına göre herkese açık test verisi, model ve eğitim verisi bilgisi olmadan bu tür "%99 doğruluk" iddiaları en iyi ihtimalle yanıltıcıdır. Flanders ve arkadaşları da GPTZero'nun şirkete ait kapalı bir araç olmasını sınırlılıklar arasında sayıyor.
Dergiler yapay zekâ izini dedektörle mi arıyor?
Yazardan istenen bir dedektör skoru değil, beyan. Uluslararası Tıp Dergisi Editörleri Komitesinin (ICMJE) Ocak 2026'da güncellenen önerilerinin V.A bölümüne göre dergi, yazarlardan gönderimde yapay zekâ destekli teknoloji kullanıp kullanmadıklarını beyan etmelerini istemeli. Kullananlar nasıl kullandıklarını hem kapak mektubunda hem makalenin uygun bölümünde anlatmalı. Çıktı yanlış, eksik ya da yanlı olabileceği için yazarlar içeriği dikkatle gözden geçirmeli; sorumluluk insanlardadır. Beyan etmemek düzeltici işlem gerektirebilir ve bazı durumlarda suistimal sayılabilir.
ICMJE önerilerinde dergilerin dedektör kullanmasına dair bir hüküm yok. V.C bölümüne göre editör yazara sormalı, yazar da yapay zekâyı kullanıp kullanmadığını ve nasıl kullandığını açıklamalı. Yayın Etiği Komitesi (COPE), yazımda, görsel üretiminde ya da veri toplama ve analizinde yapay zekâ kullanan yazarların hangi aracı nasıl kullandıklarını Gereç ve Yöntem (Materials and Methods) ya da benzeri bir bölümde açıklamasını istiyor.
Elsevier, Wiley, Taylor & Francis, Frontiers ve MDPI'ın yapay zekâ politika sayfaları da gönderilen metnin bir dedektörden geçirildiğini söylemiyor. İki yayıncı ise başka belgelerde kurum içi araçlardan söz ediyor. Springer Nature'ın 2024 duyurusuna göre Geppetto adlı araç, makale fabrikası (paper mill) faaliyetinin tipik göstergesi saydığı yapay zekâ üretimi içeriği tespit ediyor; skor yüksekse içeriği Springer Nature personeli elle kontrol ediyor. MDPI'ın 2026 blog yazısına göre Ethicality adlı araç sahte makale ve hakem raporu gibi yapay zekâ üretimi içeriği de denetliyor; araç editoryal kararın yerini almıyor, çıktılarını editörler ve araştırma bütünlüğü ekipleri inceliyor. "Dergiler makaleyi dedektörden geçirip skora göre reddediyor" genellemesi bu kaynaklardan çıkmaz.
Beyanın kapsamı da yayıncıya göre değişiyor; örneğin MDPI ve Elsevier temel dil bilgisi, yazım ve noktalama düzeltmesini beyan dışında tutuyor. Beyanın yerini ve biçimini tıbbi makalelerde yapay zekâ beyanı yazımızda ayrıntılı anlattık.
Göndermeden önce ne yapmalı?
- Yapay zekâ kullandığınız anda kaydını tutmak. Kayda aracın adı ve sürümü, tarih, aracı hangi bölümde ne amaçla kullandığınız ve çıktıyı nasıl kontrol ettiğiniz girer. Frontiers beyanda aracın adını, sürümünü, modelini ve kaynağını istiyor.
- Taslaklarınızın tarihli sürümlerini saklamak. Dosya geçmişi ve ortak yazarlarla yazışmalar metnin nasıl geliştiğini gösterir.
- Beyanı hedef derginin kuralına göre yazmak; istenen yeri ve biçimi yazar yönergesinden kontrol etmek.
- Kaynakları ve sayıları tek tek doğrulamak. ICMJE, alıntılanan her materyalin tam künyeyle kaynak gösterilmesini insanların sorumluluğuna veriyor; yapay zekâ ile üretilmiş bir materyalin birincil kaynak gösterilmesini de kabul etmiyor. Uydurma kaynak riskini 4.046 hayalet kaynak yazımızda, künyelerin nasıl doğrulanacağını ChatGPT kaynakçası doğrulama protokolümüzde anlattık.
Bu listede kendi metninizin dedektör skoru yok, çünkü dergilerin istediği bir skor değil; doğru beyan ve doğruluğu sınanmış içerik.
Editörden "metniniz yapay zekâ ile yazılmış görünüyor" yazısı gelirse ne yapmalı?
İlk iş, editörün yazısında tam olarak ne istendiğini belirlemek. Editör beyanınızı mı soruyor, bir aracın sonucunu mu bildiriyor, yoksa belirli paragraflarda bir sorun mu görüyor? Hangi araçla ve metnin hangi kısmında sonuç alındığı yazıda yoksa bunu kibarca sorabilirsiniz. Yanıt vermeden metni yeniden yazmaya girişmek doğru olmaz. Editörün sorusu metnin nasıl üretildiğiyle ilgili; bu soruyu belgeler yanıtlar.
Yapay zekâ kullandıysanız ve beyanınız bu kullanımı eksik anlatıyorsa, düzeltmenin yeri burası. Gerçek kullanımı kaydınıza dayanarak ve derginin istediği biçimde yazmak, düzeltilmiş beyanı da yanıta eklemek gerekir. Eksiği açıkça gidermek, kullanımı küçük göstermeye çalışmaktan daha sağlam bir yoldur.
Kullanmadıysanız bunu sade bir dille yazmak, tarihli taslak sürümlerini, dosya geçmişini ve ortak yazarlarla yazışmaları da hazır tutmak işe yarar. Dedektörlerin sınırlarını hatırlatmak meşrudur, ama yanıtın tamamı bu olmamalı. Erol ve arkadaşlarının "tek dayanak olmamalı" uyarısını ve ana diliniz İngilizce değilse Liang ve arkadaşlarının bulgusunu anabilir, asıl ağırlığı kendi belgelerinize verebilirsiniz.
Yanıtı sakin, kısa ve olgulara dayalı tutmakta fayda var. Editörü suçlayan ya da dedektörlerin tümüyle geçersiz olduğunu iddia eden bir ton işinize yaramaz; editör ICMJE'nin beklediği bir adımı atıyor. Konu bir soruşturmaya dönüşürse somut durumunuz için bir hukukçuya danışmak gerekir.
Dedektör skoru bir işarettir, hüküm değildir
Flanders ve arkadaşlarının ön baskısı yapay zekâ izinin tıp dergileri arasında çok eşitsiz dağıldığını düşündürüyor. Yöntemine yakından bakınca, bir dedektör skorunun tek bir makale hakkında neden hüküm olamayacağı da görülüyor. Yazarlar eşiği bir varsayımla kuruyor ve yanlış pozitif oranını tanım gereği sabitliyor; duyarlılık bilinmiyor. Güven aralığı ne eşiğin ne de dedektörün belirsizliğini taşır. Tek bir metinde bu belirsizliklerin hiçbiri ortadan kalkmaz.
Model İstatistik CRO'nun Akademik Etik, Bilimsel Dürüstlük ve Hizmet Sınırları Politikası aynı çizgiyi hizmet tarafında çiziyor; politikaya göre "kullanımın gizlenmesine veya tespit araçlarının aşılmasına yönelik talepler hizmet kapsamı dışındadır." Gönderim öncesinde metni ve kaynakları araştırmacının yanında gözden geçirdiğimiz çalışmalar için Gönderim Öncesi Makale Kontrolü ve Referans Doğruluğu ve Retraction Taraması sayfalarımıza bakabilirsiniz.
Kaynaklar
Kaynaklar 4 Kasım 2026'da kontrol edildi. Ön baskılar hakemden geçmemiştir. Yayıncı ve üretici sayfaları değişebilir; gönderim günü ilgili derginin yönergesine yeniden bakmakta fayda var.
- Flanders MD, Caunca M, Mehrotra A, Ackley SF. AI-Assisted Writing Across Medical Journals: Heterogeneity in Prevalence and Trends. medRxiv. 26.10.2026 (v1). Hakemden geçmemiş ön baskı. DOI
- medRxiv. Frequently Asked Questions. medRxiv
- Liang W, Yuksekgonul M, Mao Y, Wu E, Zou J. GPT detectors are biased against non-native English writers. Patterns (N Y). 2023;4(7):100779. DOI
- Weber-Wulff D, Anohina-Naumeca A, Bjelobaba S, et al. Testing of detection tools for AI-generated text. Int J Educ Integr. 2023;19:26. DOI
- Popkov AA, Barrett TS. AI vs academia: Experimental study on AI text detectors' accuracy in behavioral health academic writing. Account Res. 2025;32(7):1072-1088. Çevrim içi yayın 22.03.2024. DOI
- Erol G, Ergen A, Gülşen Erol B, et al. Can we trust academic AI detective? Accuracy and limitations of AI-output detectors. Acta Neurochir (Wien). 2025;167(1):214. DOI
- Villa J, Garcovich D, Lombardo L, Siciliani G, Adobes Martin M. AI text detection in dentistry: a comparative analysis across generative models. Res Integr Peer Rev. 2026;11(1):46. DOI
- Turnitin. Turnitin's AI writing detection capabilities FAQs. Turnitin Guides, 04.11.2026'da güncellenmiş kayıt. Turnitin
- Turnitin. Why is the AI Writing Detection report score showing as *%? Turnitin Help Center. Turnitin
- iThenticate. AI writing detection in the classic report view. iThenticate Guides. iThenticate
- Chechitelli A. AI writing detection update from Turnitin's Chief Product Officer. Turnitin Blog, 23.05.2023. Turnitin
- Adamson D. New research: Turnitin's AI detector shows no statistically significant bias against English Language Learners. Turnitin Blog, 26.10.2023. Turnitin
- Tian E, Cui A, Adam A. How AI Detection Benchmarking Works at GPTZero. GPTZero, 30.01.2025. GPTZero
- International Committee of Medical Journal Editors (ICMJE). Recommendations for the Conduct, Reporting, Editing, and Publication of Scholarly Work in Medical Journals. Updated January 2026. Bölüm V.A ve V.C. ICMJE
- COPE Council. COPE position, Authorship and AI tools. 2024. COPE
- Elsevier. Generative AI policies for journals. Policy updated June 2026. Elsevier
- Wiley. Using AI tools in your research. Wiley
- Taylor & Francis. AI Policy. Taylor & Francis
- Frontiers. Artificial intelligence: fair use and disclosure policy. Policies and publication ethics. Frontiers
- MDPI. Research and Publication Ethics, Artificial Intelligence. MDPI
- McKenna J. Ethicality: AI Guardrails for Research Integrity. MDPI Blog, 01.06.2026. MDPI Blog
- Springer Nature. Springer Nature unveils two new AI tools to protect research integrity. Basın duyurusu, 12.06.2024. Springer Nature