
Bir yapay zekâ araştırmasında aynı klinik soruyu üç modele beşer kez sormak, on beş bağımsız gözlem üretmez. Bu on beş yanıt tek bir olguya dayanır; aynı hekimlerce puanlandığında araya bir bağımlılık daha girer. Böyle bir araştırmanın sonuçlarına ne kadar güvenilebileceği, hangi modelin daha yüksek puan aldığından önce bu düzenin nasıl kurulduğuna bağlıdır.
Üretken yapay zekâ tabanlı sohbet botlarıyla yürütülen klinik senaryo çalışmaları, botların sağlık tavsiyesi verirken ya da klinik kanıtı özetlerken gösterdiği başarımı hazırlanmış senaryolarla değerlendiriyor. Bu çalışmalar için hazırlanan CHART rehberinin açıklama makalesine göre araştırmacılar, hasta bilgilerinin gizliliğine ilişkin kaygılar nedeniyle çoğu zaman gerçek hasta verisi yerine varsayımsal hasta olguları kullanıyor. Yapay zekânın makale yazımında kullanılması ve bunun beyanı ayrı bir konudur; onu tıbbi makalelerde yapay zekâ beyanını anlattığımız yazıda ele aldık.
Klinik senaryolar hangi hasta grubunu temsil ediyor?
Her senaryo bir hasta olgusunu anlatır ve senaryo seti bu araştırmanın örneklemidir. Hangi hastalığı, hangi klinik durumu ve hangi zorluk düzeyini temsil ettikleri, sonucun kime genellenebileceğini belirler. Yalnız açık ve tipik olgulardan oluşan bir senaryo seti, belirsiz ya da sık karşılaşılmayan durumlardaki başarım hakkında bilgi vermez. Senaryoların kaynağı, kapsamı ve zorluk dağılımı bu yüzden protokolde önceden tanımlanır. Senaryolar gerçek hasta bilgisi içermez; gerçek bir olgudan esinlenildiyse tanımlayıcı her ayrıntı çıkarılır.
CHART raporlama rehberi, istemlerin kaynaklarının ve çalışmada kullanılan istemlerin raporlanmasını öneriyor; istem geliştirmeye katılan kişilerin sayısının ve niteliklerinin yazılmasını da öneriyor. Açıklama makalesi, sohbet botlarının yanıtlarının istemin ifade biçimine çok duyarlı olduğunun gösterildiğini de hatırlatıyor. Senaryo metni, sorunun ifadesi ve varsa takip soruları bu nedenle her olgu için sabitlenir; metin değişirse yeni bir sürüm numarası alır. Açıklama makalesi, araştırmacılarla hastaların soruları farklı ifade edebileceğini ve bunun bulguların genellenebilirliğini etkileyebileceğini de belirtiyor. Tek bir ifadeye sabitlenen senaryonun sonucu o ifadeye bağlıdır; ifade farkı araştırma sorusu için önemliyse farklı ifade biçimleri önceden tanımlanıp tasarıma eklenebilir.
Modelin adı kadar sürümü ve sorgu tarihi de gerekli
"ChatGPT" ya da "GPT-4o" yazmak, hangi modelin değerlendirildiğini tek başına tanımlamaz. CHART modelin ve sohbet botunun adının, sürüm kimliğinin ve yayın ya da son güncelleme tarihinin raporlanmasını öneriyor. Açıklama makalesi GPT-4o'nun ilk yayımından bu yana birkaç kez güncellendiğini, güncellemelerin duyurulmadan ve sürüm kimliğinde fark edilir bir değişiklik olmadan yapılabileceğini belirtiyor ve "gpt-4o-2024-08-06" gibi bir sürüm dizesini örnek veriyor; tarihlerin de mümkün olduğunda yazılmasını istiyor. CHART modele hangi yolla erişildiğinin, sorgunun günü, ayı, yılı ve yapıldığı şehir ile ülkenin de raporlanmasını öneriyor; açıklama makalesine göre modeller sık güncellendiği için başarım sorgu tarihine göre değişebilir. Kapalı kaynaklı modellerde üretici ürünü ya da eğitim verisini kullanıcıların fark edemeyeceği biçimde değiştirebilir.
Modelin zamanla erişime kapanması ayrı bir sorundur. 4 Eylül 2026'da arXiv'de paylaşılan ve hakemden geçmemiş bir ön baskı, bu soruyu biyomedikal yayınlarda anılan dil modelleri üzerinden bibliyometrik bir analizle inceliyor. Yazarlara göre hakem ve yayın süreci, ticari bir modelin desteklendiği sürenin önemli bir kısmını tüketebilir; bir makale dizinlendiğinde anlattığı iş akışını yinelemek zorlaşmış ya da imkânsızlaşmış olabilir. Yazarlar dergilerin belirli bir sürüm dizesi istemesini öneriyor. Uzun süre yinelenebilmesi gereken işlerde, örneğin klinik kılavuz desteğinde ya da düzenleyici başvurularda, açık ağırlıklı modellerin tercih edilip ağırlıkların makaleyle birlikte kalıcı bir depoda arşivlenmesini de öneriyorlar. Bir çalışmanın gerçekten yeniden yapılabilmesi için aynı model ağırlıklarının yetmediğini, sıcaklık (temperature) ayarını, istemi ve çıktı biçimini kapsayan bütün çalıştırma koşullarının da gerektiğini belirtiyorlar.
Sorular ve yanıt tekrarları nasıl kaydedilmeli?
Aynı istem aynı modele yeniden verildiğinde farklı bir yanıt gelebilir. CHART açıklama makalesi, yanıtların yinelenebilirliğini zorlaştıran etkenler arasında modelin içsel rastlantısallığını, istemin yapısını, önceki sorguların bağlamını ve modelin davranış ayarlarını sayıyor. Ardışık istemlerde sonraki yanıtlar önceki konuşmadan etkilenebileceğinden, makale ayrı sohbet oturumlarının mı yoksa tek oturumda süren bir konuşmanın mı kullanıldığının yazılmasını teşvik ediyor. Yinelenebilirlik değerlendirildiyse yönteminin (örneğin tutarlılık ölçülerinin) ve sonuçlarının raporlanmasını da öneriyor. Kaç tekrar alınacağını ise araştırma sorusuna göre protokolde gerekçelendirmeyi öneriyoruz.
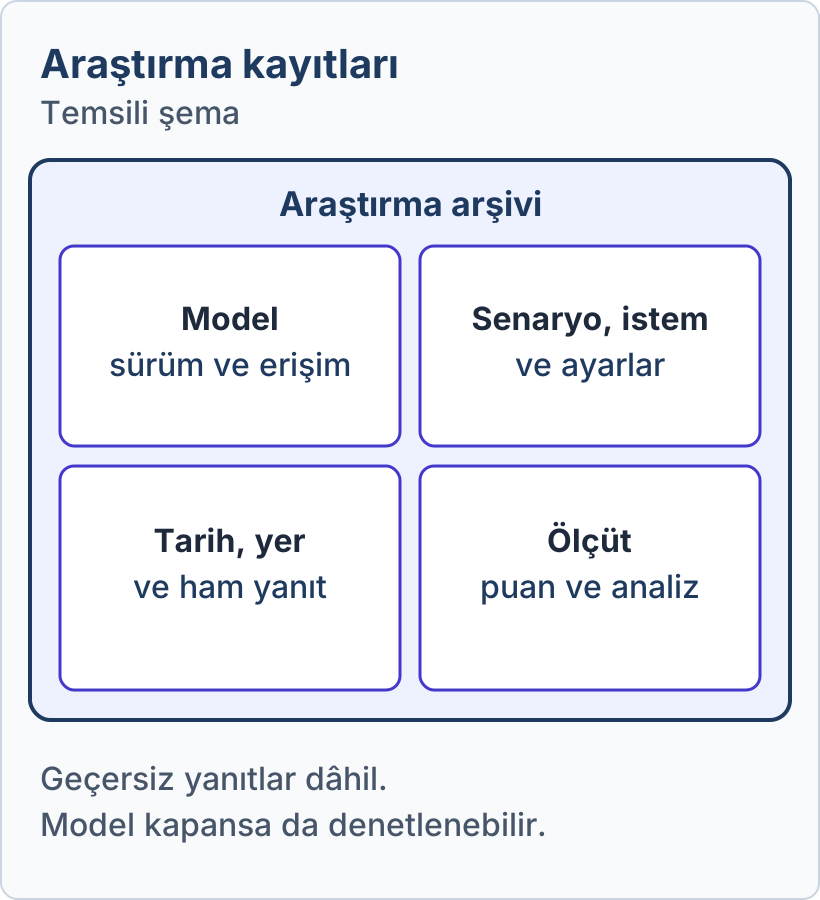
CHART, modelin bütün yanıtlarının sunulmasını öneriyor. Açıklama makalesine göre kapalı bir modelde dökümler paylaşılamıyorsa bu durum çalışmanın önemli bir sınırlılığı olarak yazılır; örneklem hesabında da eksik ya da geçersiz yanıtlar için yapılan artırmadan önceki ve sonraki örneklem büyüklükleri bildirilir. Başarılı görünen tekrarı seçip diğerlerini dışarıda bırakmak sonucu yanıltır. Bu yüzden her yanıt, geçersiz olanlar dâhil, kayda girer.
Kayıt iki tabloda tutulur. Yanıt tablosunun her satırı bir yanıttır; puan tablosunun her satırı ise bir yanıtın bir hekimce puanlanmasıdır. İki tabloyu yanıt kodu birbirine bağlar.
| Değişken | Tablo | İçerik ve gerekçe |
|---|---|---|
| yanit_kodu | Yanıt ve puan | Her yanıtın tekil kimliği; aynı yanıta verilen puanları birbirine bağlar |
| olgu_kodu, senaryo_surumu | Yanıt | Olgunun kimliği ve olgu metninin sürümü; gerçek hasta bilgisi içermez, aynı olgunun bütün yanıtlarını birbirine bağlar |
| istem_surumu | Yanıt | Soru ve takip sorularının metin sürümü; istem değişikliğinin etkisini model farkından ayırmayı sağlar |
| ifade_bicimi | Yanıt | Farklı ifade biçimleri tasarıma eklendiyse yanıtın hangisine verildiği; olgu içinde ayrı bir etkendir |
| model_surumu | Yanıt | Model ve sohbet botu adı, tam sürüm dizesi, mümkünse yayın ya da son güncelleme tarihi; ticari ad tek başına modeli tanımlamaz |
| erisim_yolu, model_ayarlari | Yanıt | Web arayüzü ya da API; erişilebilen ayarlar (sıcaklık, sistem istemi, çıktı biçimi) |
| sorgu_tarihi, sorgu_yeri | Yanıt | Modeller zamanla güncellenir, erişim yere göre değişebilir |
| oturum_no, tekrar_no | Yanıt | Sohbet oturumu ve aynı istemin kaçıncı yanıtı olduğu |
| yanit_metni, yanit_durumu | Yanıt | Ham yanıtın tamamı ve geçerli ya da geçersiz oluşu |
| degerlendirici_kodu | Puan | Puanlayan hekim; aynı hekimin puanları birbirine bağlıdır |
| puan | Puan | Önceden tanımlı ölçüte göre puan |
Hekim değerlendirmesi ve puanlama ölçütleri
CHART açıklama makalesi modelin başarımını, yanıtın referans standartla örtüşmesi olarak tanımlıyor; makaleye göre bu standardı tanımlamada en önemli kaynak kanıta dayalı klinik kılavuzlardır. Yanıt bir öneri vermek yerine bir kararı yalnızca "makul" diye niteleyebilir, sorumluluk reddi beyanıyla yetinebilir ya da birçok seçeneği sıralayabilir; bu tür yanıtların nasıl sınıflanacağı tercihen önceden belirlenip protokole yazılır. Değerlendiricilerin sayısı ve klinik uzmanlığı da raporda yer alır. Makale, değerlendiricilerin bazı modellere olumlu ya da olumsuz önyargıyla yaklaşabileceğini belirtiyor, modellerin kimliğinin gizlenmesinin düşünülebileceğini söylüyor ve körleme uygulanıp uygulanmadığının açıkça yazılmasını istiyor. Puanlamada Likert ölçekleri ya da klinik etkisi sınırlı hatalarla hasta güvenliğini etkileyebilecek ciddi hataları ayıran bir sınıflama kullanılabilir. Açıklama makalesi belirli bir başarım ölçüsü önermiyor; seçilen ölçünün gerekçesinin yazılmasını istiyor.
Gözlemciler arası uyum (değerlendiriciler arası uyum) ise ayrı bir sorudur. Koo ve Li güvenirliğin ölçümlerin tekrar üretilebilme derecesi olarak tanımlandığını aktarıyor ve bu kavramın korelasyonun yanında ölçümler arasındaki uyumu da kapsadığını belirtiyor. Açıklama makalesinin başarım tanımını bu güvenirlik tanımıyla yan yana koyduğumuzda, hekimlerin birbirine uymasının puanlamanın değerlendiriciler arası güvenirliğini gösterdiği, yanıtın doğru olduğunu ise göstermediği sonucuna varıyoruz. İki hekim yanlış bir yanıta aynı yüksek puanı verirse o yanıt üzerinde uzlaşmışlardır, ama yanıt yine yanlıştır. Gözlemciler arası uyum bu yüzden modelin başarımının yerine geçemez.
Sayısal puanlarda sınıf içi korelasyon katsayısı (ICC) kullanılıyorsa Koo ve Li, ICC'nin hangi model, tür ve tanımla hesaplandığının yazılmasını ve değerinin güven aralığıyla birlikte verilmesini öneriyor; kabul edilebilir güvenirlik için standart bir değer olmadığını da hatırlatıyor. Aynı yazarlar güvenirlik çalışmaları için pratik bir kural olarak, mümkün olduğunda en az 30 heterojen örnek ve en az üç değerlendirici öneriyor. İki hekimle yürütülen bir çalışmada bunu sınırlılık olarak yazmayı öneriyoruz. Uyum istatistiği bütün yanıtlar üzerinden hesaplandığında aynı olgudaki yanıtlar bağımsız sayılmış olur; uyum katsayısının güven aralığı bu yüzden olduğundan dar çıkabilir. Kategorik puanlarda kappa ölçüleri de kullanılabilir; seçenekleri gözlemciler arası uyum yazımızda karşılaştırdık, hesap için gözlemciler arası uyum hesaplayıcısı kullanılabilir.
Olgu, yanıt ve değerlendirici aynı analiz birimi değildir
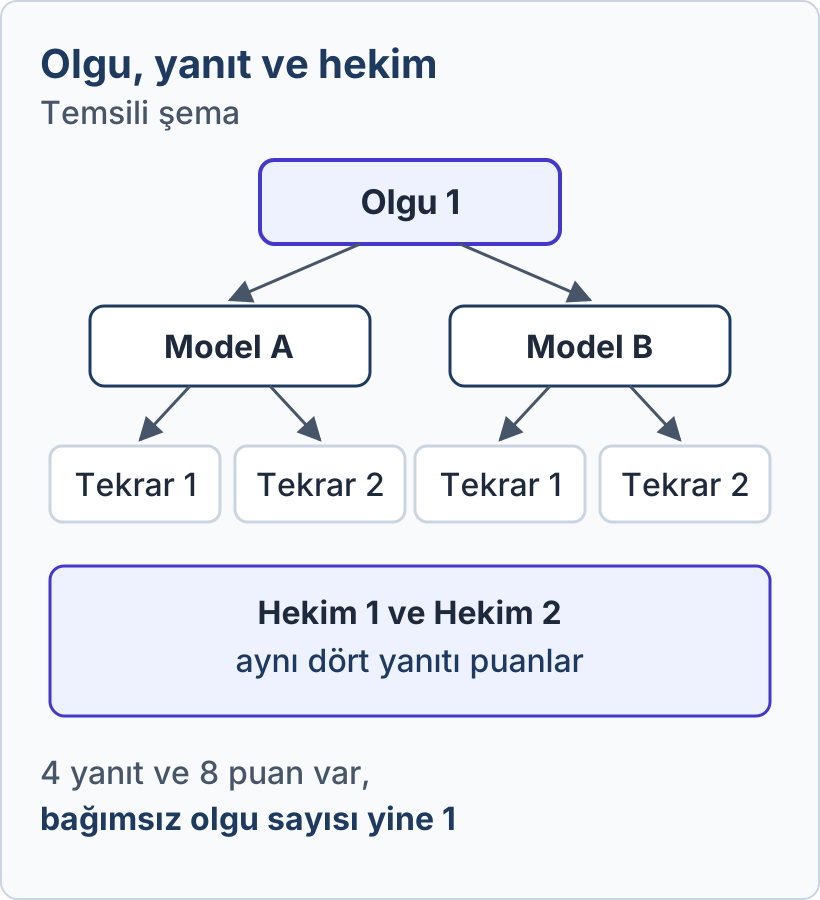
Birbirinden bağımsız seçilmiş 30 senaryonun her biri üç modele beşer kez soruluyor ve her yanıtı iki hekim puanlıyorsa 450 yanıt ve 900 puan elde edilir; olgu düzeyinde bağımsız birim sayısı ise 30'dur. Aynı olguya verilen yanıtlar ortak bir senaryodan gelir, aynı hekimin verdiği puanlar da onun puanlamadaki genel eğilimini, daha katı ya da daha hoşgörülü oluşunu yansıtır. Hekim boyutunda ise yalnız iki birim vardır; model karşılaştırması bu iki hekimin puanlarıyla sınırlı yorumlanır ve başka hekimlere genellenmesi için iki hekim yetmez. Yapı tek düzeyli de değildir. Yanıt tekrarları olgu ve model içinde yer alır, modeller aynı olgu üzerinde eşleşir, iki hekim bütün yanıtları puanladığı için hekimler ile yanıtlar çapraz bir yapı oluşturur.
Parsons ve arkadaşlarının laboratuvar araştırmaları için yazdığı istatistik makalesine göre aynı birimden alınan tekrarlı gözlemler, farklı birimlerden alınanlara göre birbirine daha çok benzeme eğilimindedir ve büyük olasılıkla bağımlıdır. Yazarlara göre bu bağımlılığı yok sayan analizde yanlış pozitif (birinci tip hata) oranı artar, istatistiksel güç ise çoğu zaman olduğundan çok yüksek tahmin edilir. En basit yol olarak birim başına bir özet değeri, daha iyi bir yaklaşım olarak karma etkili modeli gösteriyorlar. Tasarımın genellikle, birim içi değişkenliği makul kesinlikle ölçmeye yetecek sayının ötesinde birim içi gözlem eklemekle değil, bağımsız birim sayısını artırmakla iyileştiğini de belirtiyorlar. Makale dil modelleri için değil laboratuvar çalışmaları için yazıldı; aynı mantıkla bir senaryoya alınan beş yanıt beş ayrı olgu değildir. Bizim değerlendirmemize göre klinik senaryo çalışmasında bir fark daha vardır; modeller aynı olgu üzerinde karşılaştırıldığı için bağımlılığı yok saymanın etkisi tek yönlü değildir. Eşleşmeyi yok saymak gücü düşürebilir, beş tekrarı bağımsız saymak ise model farkının belirsizliğini olduğundan küçük gösterebilir. Aynı sorunu hasta ve lezyon düzeyinde analiz birimi ve veri sözlüğü yazımızda anlattık.
Bu yüzden seçilen analiz yöntemi olgu içindeki tekrarları, modeller arası eşleşmeyi ve değerlendirici yapısını hesaba katar. İkili (doğru ya da yanlış) bir puan, sıralı bir Likert puanı ve sürekli bir puan farklı yöntemler gerektirir. Bizim önerimiz, karşılaştırılan modeli sabit etki, senaryoyu ve aynı senaryo içindeki model farkını rastgele etki olarak alan karma modellerdir. Senaryo istatistiksel modele yalnız rastgele kesişimle girerse aynı olgu ve modeldeki beş tekrar yine bağımsız sayılmış olur. Puanlar hekim düzeyinde analiz ediliyorsa aynı yanıtın iki puanını birbirine bağlayan, yanıt düzeyinde bir rastgele etki de eklenir. İkili puanlarda karma etkili lojistik regresyon, sıralı puanlarda karma etkili sıralı model, sürekli puanlarda doğrusal karma model bu yapıya uyarlanabilecek seçeneklerdir. Daha basit bir yol, her olgu ve model için tek bir özet değer hesaplayıp modelleri 30 olgu üzerinde eşleştirilmiş biçimde karşılaştırmaktır. Yalnız iki hekim olduğunda hekim, istatistiksel modele sabit etki olarak girebilir ya da iki hekimin puanları önceden yazılmış bir kurala göre yanıt düzeyinde birleştirilebilir; ikili ve sıralı puanlarda ortalama yerine uzlaşı ya da üçüncü bir hekimin kararı böyle bir kural olabilir. Analiz planı birincil karşılaştırmayı, puanlama ölçütünü, karşılaştırılacak modelleri ve tekrar sayısını önceden belirtir; çok sayıda alt karşılaştırma yapıldığında yalnız olumlu sonuçların öne çıkarılması riski doğar.
Örneklem için de aynı ayrım geçerlidir. Açıklama makalesi, sohbet botlarının tavsiyelerinin doğruluğunun karşılaştırıldığı çalışmalarda örneklemi sohbet botlarının ya da hekimlerin sorgulara verdiği bağımsız yanıtların sayısı olarak tanımlıyor; örneklem büyüklüğünün tıbbi ve istatistiksel gerekçelerle, birincil sonlanıma göre önceden ve mümkünse istatistiksel yöntemle belirlenmesini, hesabın bütün bileşenlerinin ve varsayımlarının yazılmasını öneriyor. Tekrar yanıtların bu tanımda nasıl sayılacağı ise tasarıma kalır. Tekrarlar aynı olguya bağlı olduğu için hesabın temel birimini senaryo olarak alıyoruz; tekrarların ve modeller arası eşleşmenin katkısı, aynı olgudaki yanıtların birbirine ne kadar benzediği hesaba katılarak belirlenir.
Araştırmanın yinelenebilmesi için neler raporlanmalı?
CHART, üretken yapay zekâ tabanlı sohbet botlarının klinik kanıtı özetlerken ya da sağlık tavsiyesi verirken gösterdiği başarımı değerlendiren çalışmalar için 12 madde ve 39 alt maddeden oluşan bir raporlama rehberidir; maddeleri raporlama önerileridir. Altı dergi CHART rehberini 2025'te ortak olarak yayımladı. Bir eleştirel değerlendirme aracı değildir. Randomize çalışmalar ve ileriye dönük kohortlar kapsamı dışında kalıyor; farklı çalışma tasarımları için CHART uzantıları hazırlık aşamasında ve o zamana kadar yazarlar CHART'ı tasarıma uygun bir rehberle, örneğin CONSORT ya da STROBE ile birlikte kullanmaya teşvik ediliyor. Üretken olmayan yapay zekâ uygulamalarında ise yazarların daha genel raporlama rehberlerini kullanması teşvik ediliyor.
Bir sohbet botunun sağlık tavsiyesini klinik senaryolarla değerlendiren bir çalışmada CHART'ın önerileri modelin adını, sürümünü ve tarihini, açık ya da kapalı kaynak oluşunu, istemleri, erişim yolunu, sorgu tarihini ve yerini, bütün yanıtları, referans standardı, değerlendiricilerin sayısını ve körlenip körlenmediklerini, örneklemin nasıl belirlendiğini, analiz yöntemini ve protokolü kapsar. Çalışma verisine, kod deposuna ve model parametrelerine nereden erişilebileceği de belirtilir. Açıklama makalesi, ham yanıt metinlerine erişilemiyorsa bunun çalışmanın önemli bir sınırlılığı olarak yazılmasını istiyor. Açıklama makalesi, hasta verisi içermeyen klinik öncesi çalışmaların olağan etik onay sürecinden muaf olabileceğini belirtiyor ve onayı veren ya da onay gerekliliğinden muaf tutan etik kurulun adının yazılmasını istiyor.
Olgu sayısı, yanıt tekrarları ve değerlendirici puanları arasındaki ilişki, istatistiksel analiz planında araştırma başlamadan tanımlanır.
Kullanılan kaynaklar
- The CHART Collaborative. Reporting guideline for chatbot health advice studies: the Chatbot Assessment Reporting Tool (CHART) statement. BMJ Med. 2025;4(1):e001632. PMID 40761518 · DOI
- The CHART Collaborative. Reporting guidelines for chatbot health advice studies: explanation and elaboration for the Chatbot Assessment Reporting Tool (CHART). BMJ. 2025;390:e083305. PMID 40750271 · DOI
- Wolfrath N, Conroy M, Kosten T, ve ark. Model Retirement Creates Reproducibility Risk in Biomedical AI Publications. arXiv:2609.04699v1 [ön baskı, hakemden geçmemiş]. 2026. DOI
- Parsons NR, Teare MD, Sitch AJ. Unit of analysis issues in laboratory-based research. eLife. 2018;7:e32486. PMID 29319501 · DOI
- Koo TK, Li MY. A guideline of selecting and reporting intraclass correlation coefficients for reliability research. J Chiropr Med. 2016;15(2):155-163. PMID 27330520 · DOI