
Excel dosyasında her hastanın ölçüm değeri ayrı bir hücrede duruyor. Araştırma ekibi analizden önce yeni bir sütun açıp ölçümleri ortancaya göre iki gruba ayırıyor. İki gruplu tabloyu okumak kolay, sonuç da tek bir katsayıya sığıyor. Ancak bu ayrım birbirine çok yakın ölçümleri farklı gruplara atayabiliyor, birbirinden uzak değerleri ise aynı etiketin altında topluyor. Araştırmanın asıl sorusu ölçüm yükseldikçe sonucun nasıl değiştiğiyse, gruplama bu soruya cevap vermek için gereken ayrıntının bir kısmını siliyor.
Eşik koyduğumuzda hangi farklar kayboluyor?
Sürekli bir değişken ikiye ayrıldığında her kişinin gerçek değerinin yerini ait olduğu grup alır. Sonraki analiz, aynı gruptaki kişilerin bu değişken bakımından birbirinden farkını artık göremez. İki grubu karşılaştırmak her zaman yanlış değildir; ama bu karşılaştırmanın asıl sorunun hangi kısmını koruduğunu bilmek gerekir.
Kurmaca örnekte gruplama sınırı 50 birim. Aralarında yalnızca 0,2 birim bulunan 49,9 ve 50,1 farklı gruplara düşer; aralarında 19,9 birim bulunan 30 ve 49,9 ise aynı etiketi taşır. Bu sayılar gerçek hasta verisi ya da klinik bir eşik değil; gruplamanın neyi sildiğini göstermek için seçtiğimiz kurmaca değerlerdir.
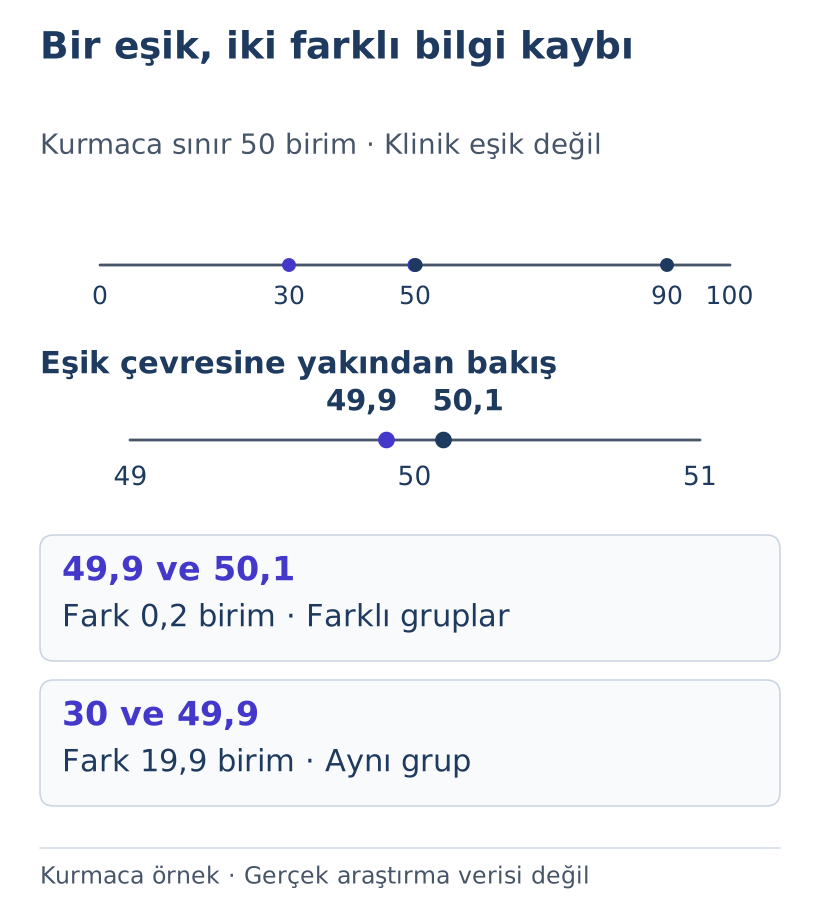
Kurmaca değerler 30; 49,9; 50,1 ve 90'dır. 50'nin altındaki değerler birinci, 50 ve üstü ikinci gruptadır. 49,9 ile 50,1 yalnızca 0,2 birim farklı olmalarına rağmen ayrı gruplara atanır; 30 ile 49,9 ise aralarında 19,9 birim bulunmasına rağmen aynı grupta yer alır.
Royston, Altman ve Sauerbrei'nin yöntem makalesi, böyle bir ikiye bölmenin güç kaybına ve artık karıştırıcılığa yol açabildiğini, veride en güçlü ilişkiyi veren eşiğin seçilmesinin ise yanlılık yaratabileceğini tartışıyor [1]. Güç kaybının boyutu araştırmadan araştırmaya değişir; bu yazıda belirli bir oran öne sürmüyoruz.
Karıştırıcı olarak modele giren bir ölçümün gruplanması ayrı bir sorun yaratır. Yaşı iki sınıfa ayıran bir model, aynı sınıftaki kişiler arasındaki yaş farkını hesaba katmaz. Grupların içindeki bu farklar hem incelenen maruziyetle hem sonlanımla ilişkiliyse, kaba sınıflama karıştırıcılığı tam olarak düzeltemeyebilir [1].
Sürekli tutmak düz çizgi çizmek anlamına gelmiyor
Bir ölçümü sayısal değeriyle regresyona almak, ilişkinin biçimine ayrıca karar vermeyi gerektirir. Doğrusal terim, açıklayıcı değişken bir birim arttığında modelin ölçeğindeki değişimin her düzeyde aynı olduğunu varsayar. Bu varsayım bazı araştırmalarda yeterlidir; bazılarında ise ilişki düşük ve yüksek değerlerde farklı seyreder.
Lojistik regresyonda doğrusal terimin varsaydığı sabit değişim, olay olasılığında değil log-odds ölçeğindedir. Bu yüzden olasılık ölçeğinde çizilen eğri düz görünmeyebilir. Odds ratio ve güven aralığı yazımızda anlattığımız ölçek ayrımı, ilişki grafiklerini okurken de yol gösterir [6].
Dolayısıyla ölçümü sürekli tutmak ile ilişkiyi doğrusal kabul etmek iki ayrı karardır. Birincisi ölçümün ayrıntısını korur, ikincisi bu ayrıntının sonlanıma nasıl bağlandığına dair bir biçim seçer. İlişkinin düz çizgiden ayrılması ile ölçümün normal dağılmaması da birbirinden bağımsızdır; ölçümün histogramı ilişkinin biçimini tek başına göstermez.
Durrleman ve Simon'un 1989 tarihli makalesi, doğrusallık varsayımı uymadığında kübik spline'ların nasıl kullanılabileceğini ele alıyor [2]. Bu, her ölçüme kıvrımlı bir eğri uydurmak gerektiği anlamına gelmiyor.
Güncel bir araştırmada aynı ölçümün iki farklı analizi
Conlon ve arkadaşlarının 28 Eylül 2026'da JAMA Network Open'da yayımlanan gözlemsel çalışması bu ayrımı somut biçimde gösteriyor. Araştırmacılar birincil analizde, hastaneye başvurudan ilk antibiyotiğe kadar geçen süreyi hipotansiyonu olanlarda 3, olmayanlarda 5 saatlik eşikle ikiye ayırıyor. İkincil analizde ise bu sürenin 30 günlük ölümle ilişkisini, lojistik modele eklenen kısıtlı kübik spline terimleriyle inceliyor [3].
Yazarlar tartışma bölümünde, idari karşılaştırma için seçtikleri sınırın, ilişkinin biyolojik olarak birdenbire değiştiği bir noktayı temsil etmeyebileceğini açıkça belirtiyor [3]. Bu örnekten antibiyotik zamanlaması için bir saat önerisi ya da hasta düzeyinde bir karar çıkarmıyoruz. İstatistik açısından öğretici olan, süreç ölçütü için konan eşiğin maruziyet ile sonlanım arasındaki ilişkinin biçimini tarif etmemesi; çalışma da bu iki soruyu iki ayrı analizle yanıtlıyor.
Bir eşik dışarıdaki bir standarda dayanabilir ve o standardı karşılayan hastaların oranını hesaplamak için gerekebilir. Aynı değişkenin sonlanımla ilişkisi araştırılırken ise değerlerin bütün aralığına bakmak ek bilgi verir. İki analiz aynı makalede yer alacaksa her birinin hangi soruyu yanıtladığı açıkça yazılır.
Spline ile ilişkinin biçimini modellemek
Kısıtlı kübik spline, ölçüm aralığını parçalara bölüp her parçaya kübik bir eğri uyduran ve bu parçaları pürüzsüz biçimde birleştiren bir modelleme yaklaşımıdır. Parçaların birleştiği noktalara düğüm denir. “Kısıtlı” sözcüğü, en dıştaki düğümlerin ötesinde eğrinin doğrusal olmaya zorlanmasını anlatır; lojistik modelde bu doğrusallık log-odds ölçeğindedir, olasılık ölçeğindeki uçlar düz olmak zorunda değildir. R'nin rms paketinin resmî belgeleri bu yapıyı ve modelde kullanımını açıklıyor [5,6].
Düğümler hastaları biyolojik sınıflara ayıran eşikler değil, modelin eğriyi kurarken kullandığı bağlantı noktalarıdır. Bir düğümün 50'de olması, 49,9 ile 50,1 arasında klinik bir sıçrama olduğunu göstermez; eğri bu noktadan da kesintisiz geçer.
İkinci kurmaca örnekte dokuz ölçüm var ve sonuç, ölçüm arttıkça önce azalıyor, sonra artıyor. Değerleri iki gruba ayıran model her grup için tek bir düzey veriyor. Doğrusal model bu simetrik örnekte yatay bir çizgide kalıyor. Spline ise iki uç ile orta bölüm arasındaki farkı yakalayabiliyor. Şekil gerçek bir araştırma bulgusu değil; bu kadar az gözlemle model kurmayı da önermiyor.
Bu kurmaca veride ölçümü 50'nin altında olanların sonuç ortalaması 35, 50 ve üzerinde olanların 32 birim. Aradaki üç birimlik fark, iki uçtaki yüksek sonuçları ve ortadaki düşük sonuçları yansıtmıyor. Gruplama veriyi iki basamakla özetliyor, spline ise aradaki biçimi korumaya çalışıyor.
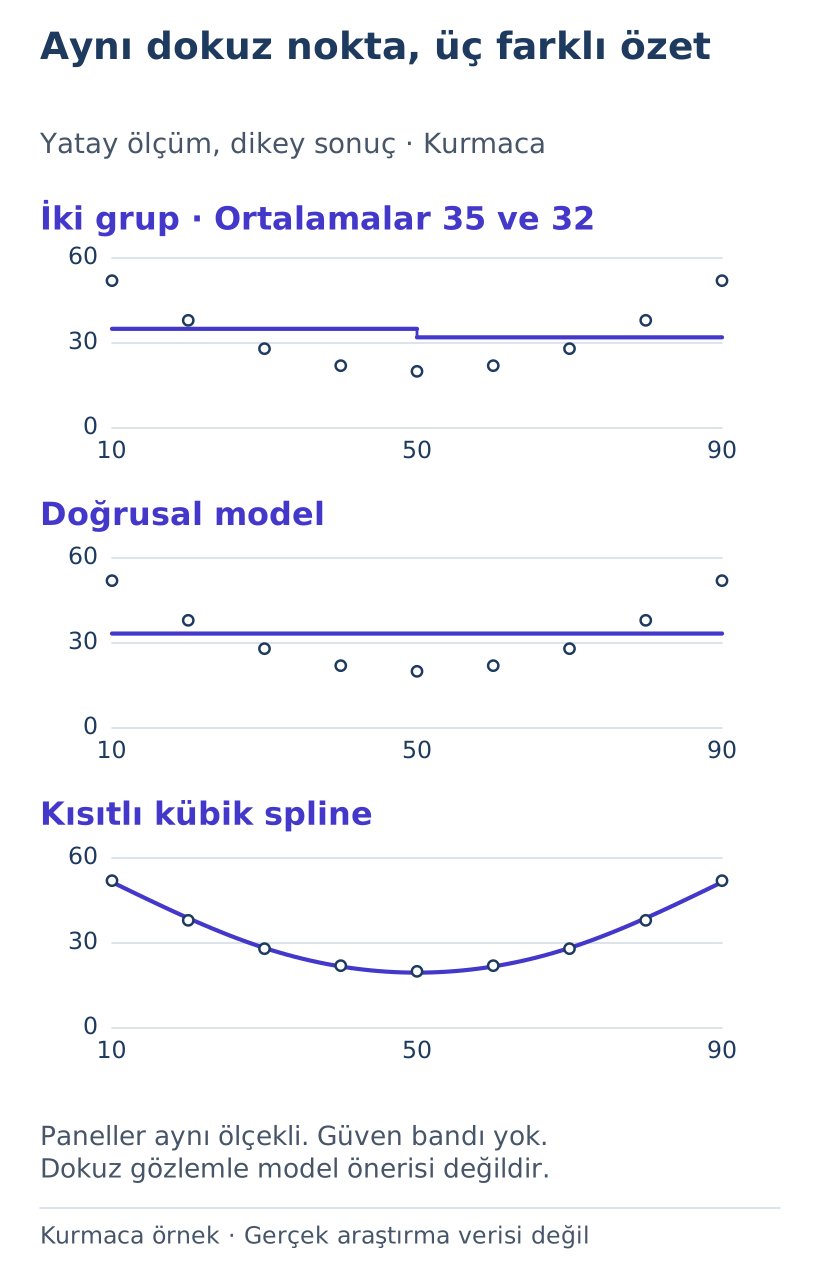
Kurmaca x değerleri 10'dan 90'a onar birim artar; y değerleri sırasıyla 52, 38, 28, 22, 20, 22, 28, 38 ve 52'dir. x<50 grubunun ortalaması 35, x≥50 grubunun ortalaması 32 birimdir. En küçük kareler doğrusal modeli yaklaşık 33,333 birimlik yatay bir çizgi verir. Düğümleri 10, 30, 70 ve 90'da olan kısıtlı kübik spline uçlarda yüksek, ortada düşük sonuç gösterir. Bunlar gerçek gözlem veya klinik etki değildir.
Eğrinin buradaki düzgün görüntüsü, gerçek veride doğru modelin bulunduğunu kanıtlamaz; örneği bilerek eğri bir ilişki üretecek biçimde kurduk. Gerçek bir araştırmada ilişkinin biçimi önceden bilinmez ve rastlantısal dalgalanma da kıvrım oluşturabilir.
Esneklik arttıkça veri ihtiyacı da artıyor
Düğüm sayısı ve modeldeki diğer terimler, kestirilecek parametre sayısını belirler [5]. Bir ölçüm için daha ayrıntılı bir biçim kurmak eldeki bilgiyi çoğaltmaz; aynı veriden daha fazla parametre kestirmeyi gerektirir. Olay sayısı sınırlıysa birçok değişkeni aynı anda esnek eğrilerle modellemek belirsizliği büyütebilir. Ne kadar esneklik kullanılacağı, eldeki veriye ve araştırmanın önceliğine göre belirlenir.
Seçilen biçimin gerekçesi analiz planına yazılabilir; düğümlerin sayısı ve yeri, karşılaştırılacak modeller ve sonuçların raporlanacağı ölçek bu gerekçenin parçasıdır. Sonuçlara baktıkça farklı seçenekler deneyip yalnız en anlamlısını raporlamak, önceden tanımlanmış tek bir analizle aynı güvenilirliği taşımaz [1].
R'nin rms paketi, bir değişkenin sonlanımla genel ilişkisini ve doğrusal biçimden sapmasını ayrı testlerle değerlendirmeye olanak tanıyor [5]. Bir ölçümün sonlanımla ilişkili olması, eğrinin kıvrımlı olduğunu göstermez. Doğrusallıktan sapma için kanıt bulunamaması da ilişkinin kusursuz bir doğru olduğunu kanıtlamaz.
Eğri, belirsizlik ve veri yoğunluğu birlikte okunuyor
İlişki grafiğinde yalnız tahmin çizgisi gösterildiğinde, gözlemlerin seyrek olduğu uçlar olduğundan daha ikna edici görünebilir. Grafiğe güven aralığı ve ölçümlerin dağılımı da eklendiğinde eğrinin hangi bölümünün az veriye dayandığı görülür. Her ölçüm değeri için ayrı hesaplanan noktasal güven aralıkları ile eğrinin tamamını birlikte kapsaması amaçlanan eşzamanlı güven bandı da farklı şeylerdir [5].
Modelde başka değişkenler de varsa, çizilen eğrinin hangi hasta profilini temsil ettiği önem kazanır. Yaş ve diğer değişkenler belirli değerlerde sabit tutularak elde edilen olasılık tahmini o profile aittir [5]; bütün araştırma grubunun ortalamasıyla aynı olmak zorunda değildir. Etkileşim içermeyen bir lojistik modelde bu sabit değerler değiştiğinde log-odds ölçeğindeki eğri yalnız yukarı ya da aşağı kayar, olasılık ölçeğinde ise eğrinin hem düzeyi hem biçimi değişebilir. Bu yüzden grafiğin açıklamasında sabit tutulan değerlerin yazılması, okuyucuların aynı eğriyi farklı hasta gruplarına ait sanmasını önler.
Sonucu doğru yorumlamak için tahminin hangi ölçekte verildiğini bilmek gerekir. Lojistik modelin tahmini log-odds ölçeğinde olabilir; ters logit dönüşümü bu değeri olay olasılığına çevirir. R'nin resmî belgesindeki örnek bu ayrımı gösteriyor [6]. İki ölçüm düzeyi karşılaştırılacaksa hangi iki değerin ve diğer değişkenler için hangi değerlerin kullanıldığı yazılır. Böylece esnek model tek bir sabit katsayıya indirgenmeden araştırma sorusuna uygun bir karşılaştırma sunulur. Eğri üzerinde iki nokta seçtiğimizde yeni hasta grupları oluşturmuyor, aynı modelden elde edilen iki tahmini karşılaştırıyoruz.
Hernandez ve arkadaşlarının 3 Eylül 2026 tarihli kohort çalışması, aynı maruziyeti doğrusal terimle, spline ile ve farklı kategori tanımlarıyla modelliyor; merkez içindeki kümelenmeyi de hesaba katıyor [4]. Bu örnek, model biçimini seçmenin gözlemler arasındaki bağımlılığı ya da ölçüm sorunlarını kendiliğinden çözmediğini hatırlatıyor.
Eğrinin belirli bir değerden sonra yükselmesi, o değerin bir tedavi eşiği olduğunu göstermez. Gözlemsel veride daha esnek bir biçim kurmak artık karıştırıcılığı da kendiliğinden gidermez; Conlon ve arkadaşları bu sınırlılığı kendi çalışmalarında açıkça tartışıyor [3]. Esnek eğri ilişkiyi daha ayrıntılı anlatır, ama uygun bir tasarımın yerini tutmaz.
Eşik gerektiğinde amacı baştan tanımlamak
Klinik sınıflama, tanısal değerlendirme ya da süreç denetimi için kategori gerekebilir. Belirleyici olan kategorinin kendisi değil, hangi amaçla kullanıldığıdır. Önceden tanımlanmış bir klinik sınıflamayı raporlamak ile veride en küçük p değerini veren sınırı aramak aynı şey değildir [1].
ROC analizi ve cut-off seçimi yazımızda ele aldığımız tanısal eşik, açıklayıcı değişkenin regresyondaki biçiminden farklı bir amaca hizmet eder. Tanı kararında kullanılan bir sınır, ilişkinin tamamını iki basamakla özetlemeye yetmeyebilir. Bu nedenle aynı araştırmada kategorik bir özet tablonun ve sürekli modelin birlikte kullanılması çelişki oluşturmaz.
İstatistiksel analiz planı yazımızda anlattığımız hazırlık, bu kararı veri toplandıktan sonra verilen bir yazılım tercihi olmaktan çıkarıp araştırma sorusunun parçası yapıyor. Veri toplama formunda ölçümün gerçek değerinin saklanması, sonradan farklı biçimlerin değerlendirilebilmesini sağlar; yalnız grup etiketi kaydedilmişse kaybolan ayrıntı geri getirilemez.
Okunaklı bir sonuç için ölçümü ikiye bölmek gerekmiyor. Model İstatistik CRO, modelleme aşamasında açıklayıcı değişkenlerin biçimini, sonuçların sunulacağı ölçeği ve verinin taşıyabileceği karmaşıklığı birlikte değerlendiriyor; planlama aşamasında da bu kararları sonlanımla ve örneklem gerekçesiyle ilişkilendiriyor.
Kaynaklar
- Royston P, Altman DG, Sauerbrei W. Dichotomizing continuous predictors in multiple regression: a bad idea. Statistics in Medicine. 2006;25(1):127–141. İlk çevrim içi yayım 11 Ekim 2005. doi:10.1002/sim.2331.
- Durrleman S, Simon R. Flexible regression models with cubic splines. Statistics in Medicine. 1989;8(5):551–561. doi:10.1002/sim.4780080504.
- Conlon A, et al. Presenting Symptoms and Antibiotic Timing Among Hospitalized Adults With Presumed Sepsis. JAMA Network Open. 2026;9(9):e2635575. 28 Eylül 2026. doi:10.1001/jamanetworkopen.2026.35575.
- Hernandez A, et al. Prenatal Water Fluoride Exposure and Children's Behavioral Problems. JAMA Network Open. 2026;9(9):e2629389. 3 Eylül 2026. doi:10.1001/jamanetworkopen.2026.29389.
- Harrell FE Jr. rms: Regression Modeling Strategies. Sürüm 8.1-1.
rms.trans,anova.rmsvePredictbölümleri. Resmî CRAN başvuru belgesi. Erişim 2 Ekim 2026. - R Core Team. Predict Method for GLM Fits.
predict.glmişlevinintypevenewdataaçıklamaları. R'nin resmî başvuru belgesi. Erişim 2 Ekim 2026.