
Bir ölçeğin Cronbach alfası, orijinal çalışmada 0,87 iken bir Türkçe uygulamada 0,42'ye düşebiliyor. İlk akla gelen soru "veri mi kötü, yoksa ölçek mi Türkiye'de çalışmıyor?" oluyor; oysa sorun başka yerde olabilir. Deneyimimizde sık karşılaşılan bir neden, birkaç ters maddenin çevrilmeden toplama katılması.
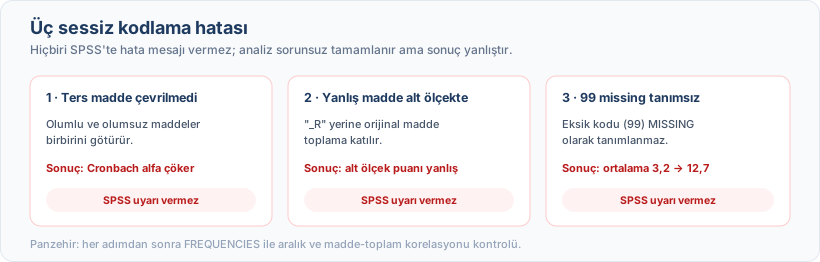
Anket verisi kodlama hatalarının ortak özelliği sessiz olmaları. SPSS, alfa negatife düşmedikçe uyarı vermez; yanlış kodlanmış veriyle analizi sorunsuz tamamlar ve araştırmacı farkında olmadan hatalı bulgulara dayanır. Aşağıda sık karşılaşılan kodlama hataları ve bunların SPSS syntax ile çözümü yer alıyor.
Ters madde: küçük unutma, büyük hasar
Ters maddeler, katılımcının içeriğe bakmadan hep onaylayarak yanıt verme eğilimini (acquiescence bias) kontrol etmek için ölçeklere yerleştiriliyor. İş doyumu ölçeğinde "İşimden memnunum" olumlu bir madde. "İşe gitmek istemiyorum" ters madde. İkisi aynı şeyi ölçüyor ama zıt yönde.
Ters maddeler çevrilmeden toplam puan hesaplandığında olumlu ve olumsuz maddeler birbirini götürür. Toplam puan ortaya yakın bir yerde sıkışır, varyans düşer, ölçeğin iç tutarlılığını gösteren Cronbach alfa (Tavakol ve Dennick 2011) çöker ve grup farklılıkları kaybolur.
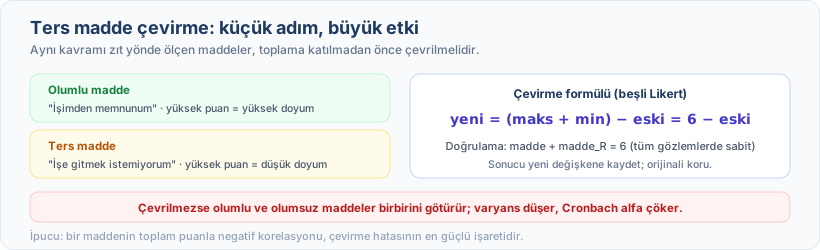
Çevirme formülü: yeni değer = (ölçek maksimum + ölçek minimum) - orijinal değer. Beşli Likert'te (1-5): yeni = 6 - eski. SPSS'te iki yol var:
RECODE yöntemi (daha okunabilir):
RECODE madde3 madde7 madde12 madde18
  (1=5) (2=4) (3=3) (4=2) (5=1)
  INTO madde3_R madde7_R madde12_R madde18_R.
EXECUTE.
COMPUTE yöntemi (daha kısa):
COMPUTE madde3_R = 6 - madde3.
COMPUTE madde7_R = 6 - madde7.
COMPUTE madde12_R = 6 - madde12.
COMPUTE madde18_R = 6 - madde18.
EXECUTE.
Ters kodlanmış maddeleri yeni değişkenlere kaydetmek kritik; orijinallerin üzerine yazılırsa bir hata yapıldığında geri dönüş yolu kalmaz. "_R" son eki hangi maddelerin çevrildiğini açıkça gösterir.
Doğrulama da zorunlu. Orijinal madde ile ters kodlanmış maddenin toplamı sabit olmalı (beşli ölçekte 6):
COMPUTE dogrulama = madde3 + madde3_R.
FREQUENCIES dogrulama.
Tüm gözlemlerde 6 çıkması gerekiyor. Farklı bir değer, kodlama hatası olduğunu gösteriyor.
Uyarı
Ters kodlama hatasının belirgin bir göstergesi, SPSS'te RELIABILITY çıktısındaki madde-toplam korelasyonu. Bir maddenin toplam puanla negatif korelasyon göstermesi, o maddenin çevrilmesi gerektiği hâlde çevrilmediğine ya da yanlışlıkla çift çevrildiğine (orijinal hâline döndüğüne) işaret ediyor. Cronbach alfa analizinde "Alpha if item deleted" sütununda bir maddenin çıkarılmasıyla alfanın belirgin yükselmesi de aynı soruna güçlü bir ipucu.
Alt ölçek hesaplama: hangi madde nereye?
Çoğu standart ölçek birden fazla alt boyuttan oluşuyor. Her alt boyut belirli maddelerin birleşiminden hesaplanıyor. Tipik hata, bir maddeyi yanlış alt ölçeğe dâhil etmek. Deneyimimizde özellikle 30-40 maddelik uzun ölçeklerde madde numarası karışıklığı sık yaşanıyor.
* Alt Olcek 1: Maddeler 1, 2, 3_R, 4, 5.
COMPUTE altolcek1 = madde1 + madde2 + madde3_R + madde4 + madde5.

* Alt Olcek 2: Maddeler 6, 7_R, 8, 9, 10_R.
COMPUTE altolcek2 = madde6 + madde7_R + madde8 + madde9 + madde10_R.

* Toplam Puan.
COMPUTE toplam = altolcek1 + altolcek2.
EXECUTE.
Dikkat: ters kodlanmış maddelerin "_R" biçimlerini kullanmak gerekiyor. Orijinal maddeyi kullanırsanız toplam puan yanlış çıkar ama SPSS size hata vermez. Sessiz hata.
Toplam mı ortalama mı? Ölçeğin puanlama kılavuzuna bağlı. Alt ölçeklerdeki madde sayısı farklıysa ortalama kullanmak karşılaştırmayı kolaylaştırır. Toplam puan ise ölçeğin orijinal normlarıyla (kesim değerleri gibi) karşılaştırma yapılacaksa tercih edilir.
Eksik maddesi olan katılımcıları tamamen kaybetmemek için MEAN.n fonksiyonu değerli:
* 5 maddeli alt olcekte en az 4 gecerli madde varsa ortalama hesapla.
COMPUTE altolcek1_ort = MEAN.4(madde1, madde2, madde3_R, madde4, madde5).
EXECUTE.
Eksik yanıt: 99 yazan hücre ortalamayı uçurur
Anket verilerinde eksik yanıt kaçınılmaz. Katılımcı bir maddeyi atlamış, birden fazla seçenek işaretlemiş veya anketi yarım bırakmış. Sorun eksik yanıtın kendisi değil, kodlanma biçimi.
Bazı araştırmacılar eksik yanıtları 99, 999 veya -1 ile kodluyor. Buraya kadar sorun yok. Sorun, SPSS'te bu değerleri MISSING VALUES olarak tanımlamayı unutmaları. 99 değeri ortalamalara, toplam puanlara ve korelasyonlara dâhil oluyor. Yanıtların yaklaşık %10'u 99 kodluysa beşli ölçekte ortalamasının 3,2 olması gereken bir değişken 12,8 çıkıyor. Ama SPSS hata vermiyor.
* Ilk is: eksik veri kodlarini tanimla.
MISSING VALUES madde1 TO madde20 (99).

* Birden fazla eksik veri kodu varsa:
MISSING VALUES madde1 TO madde20 (99, 98, 97).
* 99=Yanitsiz, 98=Uygulanamaz, 97=Birden fazla isaretleme.
Eksik madde için ölçeğin kılavuzunda bir kural varsa o uygulanıyor; örneğin RAND 36'nın puanlaması yanıtlanan maddelerin ortalamasını alıyor. Kılavuzda kural yoksa önceden bir eşik belirleyip yöntem bölümünde yazmak gerekiyor. Sık kullanılan bir eşik, maddelerin en az %80'inin yanıtlanmış olması; on maddelik bir ölçekte bu en fazla iki eksik madde demek. Eksik madde sayısı bu sınırı aşan katılımcının ölçek puanı hesaplanmıyor ama katılımcı diğer analizlerde kalıyor. Eksik veri analizi yöntemlerini ayrı yazımızda ayrıntılı ele aldık.
Demografik kodlama: tutarsızlık frekans tablolarını bozar
Cinsiyetin bir yerde "1=Kadın, 2=Erkek", başka bir yerde "0=Erkek, 1=Kadın" diye kodlanması ya da yaş grubunda bir katılımcıya 30-39, diğerine 30-40 aralığının verilmesi tipik örnekler. Bu tutarsızlıklar çapraz tabloları anlamsızlaştırır.
* Deger etiketleri.
VALUE LABELS cinsiyet 1 'Kadin' 2 'Erkek'.
VALUE LABELS egitim 1 'Ilkokul' 2 'Ortaokul' 3 'Lise' 4 'Lisans' 5 'Lisansustu'.

* Olcek duzeyleri.
VARIABLE LEVEL cinsiyet (NOMINAL).
VARIABLE LEVEL egitim (ORDINAL).
VARIABLE LEVEL yas (SCALE).
EXECUTE.
Sürekli değişkenleri (yaş gibi) kategorize etmek bilgi ve güç kaybına neden olur; ortanca değerden ikiye bölmek, verinin üçte birini atmak kadar güç kaybettiriyor (Altman ve Royston, 2006). Mümkünse değişkeni sürekli hâliyle analiz etmek tercih edilmeli. Gruplandırma yalnız tanımlayıcı tablolarda ya da klinik olarak anlamlı kesim noktaları varsa yerinde. Sürekli bir değişkenin modele doğrusal terimle ya da spline ile nasıl alınabileceğini sürekli değişkenleri modelleme yazımızda anlattık.
Kodlama Protokolü: Baştan Sona
Ölçek kılavuzlarını toplamak
Her ölçeğin orijinal geliştirme makalesi ve Türkçe uyarlama çalışması edinilir; ters maddeler, alt ölçek yapısı ve puanlama formülü not edilir.
Kodlama sözlüğü (codebook) hazırlamak
Her değişkenin adı, etiketi, veri türü, olası değerleri, eksik veri kodu ve hesaplama formülünü içeren referans belgesi oluşturulur; bu belge makale yazımında temel başvuru kaynağıdır.
SPSS syntax dosyası oluşturmak
Tüm kodlama işlemleri syntax dosyasında yapılır. Menüden yapılan işlemler kendiliğinden düzenli bir syntax dosyasına dönüşmüyor; bu yüzden her iletişim kutusunda Paste düğmesiyle işlemi syntax'a aktarmak ve dosyayı saklamak gerekiyor.
Sırayla uygulamak ve doğrulamak
Değer etiketleri, ters kodlama, doğrulama, alt ölçek hesaplama ve aralık kontrolü sırayla uygulanır; her adımdan sonra FREQUENCIES komutuyla kontrol edilir.
Ham veriyi korumak
Orijinal veri dosyası salt okunur saklanır, kodlanmış veri seti farklı isimle kaydedilir; hata durumunda sıfırdan başlayabilmek için bu ayrım şart.
Veri giriş doğrulama: ilk iş frekans tablosu
Klinik araştırmalarda tekli veri girişinin ortalama hata oranı %0,29, yani yaklaşık binde 3 (Garza ve ark., 2025). Küçük görünüyor ama 400 gözlem ve 30 değişkenlik, 12.000 hücrelik bir veri setinde bu yaklaşık 35 hata demek.
Çift veri girişinde aynı veriler iki kişi tarafından bağımsız girilir ve uyumsuzluklar orijinal forma bakılarak çözülür; aynı meta-analizde hata oranı en düşük yöntem bu (binde 1,4). Ama deneyimimizde çoğu araştırma bütçesi buna izin vermiyor.
En temel kontrol, tüm değişkenlerin frekans tablosunu çalıştırmak. Bu basit adım aralık dışı değerleri (beşli ölçekte 6 veya 0), yanlış kodlamaları ve eksik veri sorunlarını anında ortaya çıkarıyor.
FREQUENCIES madde1 TO madde_son.
DESCRIPTIVES altolcek1 altolcek2 toplam /STATISTICS=MIN MAX MEAN STDDEV.
Minimum ve maksimum değerlerin beklenen aralıkta olduğunu doğrulamak, veri temizleme kontrol listemizdeki ilk adım.
Türkiye bağlamı: uyarlama çalışmalarının tuzakları
Türkçeye uyarlanmış ölçeklerin sayısı artıyor ama kalite değişken. Bazı uyarlama makalelerinde ters madde bilgisi eksik, alt ölçek yapısı orijinalden farklı bulunmuş veya puanlama yönergesi yeterince ayrıntılı verilmemiş. Orijinal İngilizce kaynağa da başvurmak çoğu zaman zorunlu.
SPSS'in yalnız menüden kullanılması da sık karşılaşılan bir sorun. Deneyimimizde tıp fakültelerindeki istatistik eğitimlerinde syntax kullanımı çoğu zaman yüzeysel kalıyor. Menüden yapılan kodlama kendiliğinden düzenli bir syntax dosyasına dönüşmüyor; her iletişim kutusunda "Paste" ile işlemi syntax'a aktarıp dosyayı saklamak gerekiyor. Syntax dosyası oluşturma alışkanlığı, araştırmanın tekrarlanabilirliğini belirgin biçimde artırıyor.
Kültürel farklılıklar da madde düzeyinde etki edebiliyor. Orijinal ölçekte ters madde olarak işlev gören bir ifade, Türkçe çevirisinde aynı işlevi görmeyebilir. Bu durumda doğrulayıcı faktör analizi sonuçlarını dikkatle incelemek ve gerekirse madde bazında düzenleme yapmak gerekiyor. Doğru kodlama ve iyi uyum gösteren bir faktör modeli de ölçeğin farklı hasta gruplarında aynı biçimde çalıştığını tek başına göstermez; grup karşılaştırmasından önce ölçüm değişmezliğinin nasıl sınandığını hasta gruplarında ölçek karşılaştırması yazımızda anlattık.
Genel kategorik değişken kodlama ilkeleri anket dışındaki değişkenler için de aynı mantığı taşıyor; ikisi birbirini tamamlıyor.
Model İstatistik olarak anket tabanlı çalışmalarda veri analizi desteği verirken, sorunların yaklaşık yarısının analiz öncesi kodlama aşamasından kaynaklandığını görüyoruz. Doğru kodlanmış veri, analizin temelini sağlam kılıyor; yanlış kodlanmış veri ise en gelişmiş istatistiksel yöntemi bile anlamsız hâle getiriyor.
Her kodlama adımını syntax dosyasına yazmak, her ters maddeyi doğrulamak ve her alt ölçeği kontrol etmek, araştırmanın güvenilirliğinin temelini oluşturuyor.
Kullanılan kaynaklar
- Tavakol M, Dennick R. Making sense of Cronbach's alpha. International Journal of Medical Education. 2011;2:53-55. · DOI
- Garza MY, ve ark. Error rates of data processing methods in clinical research: a systematic review and meta-analysis. Int J Med Inform. 2025;195:105749. PMID 39647291
- Altman DG, Royston P. The cost of dichotomising continuous variables. BMJ. 2006;332(7549):1080.
- RAND Corporation. 36-Item Short Form Survey (SF-36) Scoring Instructions.
- IBM. SPSS Statistics 27 Command Syntax Reference; SPSS Statistics 27 Core System User Guide.
- McHugh ML. Interrater reliability: the kappa statistic. Biochem Med. 2012;22(3):276-282.