
Yüz yirmi hastanın verisi toplanıp SPSS'te analiz çalıştırıldığında, sonuç penceresinde beklenenden düşük bir örneklem (örneğin "N=87") görmek sık rastlanan bir durum. Aradaki 33 hasta kaybolmuş değil. Bazılarının laboratuvar sonucu eksik, birkaçı anketi yarım bırakmış, birinin kaydında iki değişken hiç girilmemiş. Hepsi toplandığında veri setinin dörtte birine yakını delik deşik olabiliyor. SPSS bu gözlemleri varsayılan olarak listeden siliyor (listwise) ve %80 güç için tasarlanmış bir çalışmanın gücü %65'e kadar inebiliyor. Eksik veriyi bir teknik ayrıntı değil, stratejik bir karar olarak ele almak bu yüzden gerekiyor.
Eksik verinin ne olduğu ve silme ile doldurma seçeneklerinin temel karşılaştırması için eksik veri: silmek mi doldurmak mı yazımıza bakabilirsiniz. İleri düzeyde ise eksiklik mekanizmasının değerlendirilmesi, çoklu imputasyon ve duyarlılık analizi öne çıkıyor.
Mekanizmayı anlamadan yöntem seçemezsiniz
Eksik veri analizi, "hangi kutucuğu dolduracağım" sorusuyla değil, "veri neden eksik?" sorusuyla başlıyor. Rubin'in 1976'da tanımladığı üç mekanizma, tüm stratejinin temelini oluşturuyor.
Laboratuvar numunesinin taşıma sırasında kırılması ya da veri giriş görevlisinin bir satırı atlaması, tamamen rastgele kayba (MCAR) örnektir. Eksiklik hiçbir değişkenle ilişkili değil ve gerçek hayatta çok nadir.
Yaşlı hastaların genç hastalara göre daha fazla vizit kaçırması, düşük eğitim düzeyindeki katılımcıların anketi daha sık yarım bırakması, koşullu rastgele kayba (MAR) örnektir. Eksiklik gözlenen değişkenlerle açıklanabiliyor ve çoklu imputasyon bu varsayım altında geçerli sonuç veriyor.
Ağır depresyondaki hastanın depresyon ölçeğini doldurmayı reddetmesi rastgele olmayan kayba (MNAR) örnektir; yan etki nedeniyle çalışmadan ayrılma da, kayıtlı değişkenler hesaba katıldığında bile gözlenmeyen sonuçla ilişkili kalıyorsa bu sınıfa girer. En sorunlu durum bu; standart yöntemler yanlı sonuç üretebiliyor. Hasta bildirimli sonuçlarda bu sorunun tedaviyi bırakma, ölüm ve beklenen form sayısıyla birlikte nasıl planlanabileceğini hasta bildirimli sonuçlar yazımızda ele aldık.
Eksik veri mekanizması belirleme
Mekanizmayı kesin olarak belirlemek istatistiksel olarak imkânsız, çünkü MNAR tanımı gereği gözlenemeyen veriye dayanıyor. Bu yüzden pratikte MAR varsayımını kabul edip, MNAR olasılığını duyarlılık analiziyle değerlendirmek standart yaklaşım.
Little's MCAR testi: Ne söylüyor, ne söylemiyor?
Little's MCAR testi, farklı eksiklik örüntülerine sahip alt grupların ortalamalarını karşılaştıran bir ki-kare testi. p>0,05 ise MCAR reddedilemiyor. p<0,05 ise veriler MCAR ile uyumsuz; ama MAR mı MNAR mı olduğunu test söylemiyor.
SPSS, Analyze > Missing Value Analysis menüsünde EM seçildiğinde Little's MCAR testini EM tablolarının dipnotunda veriyor. R'de naniar::mcar_test(data) kullanılabiliyor; eski kaynaklarda geçen BaylorEdPsych paketi ise 2020'de CRAN'dan kaldırıldı.
Büyük örneklemlerde klinik olarak önemsiz farklılıklar bile istatistiksel anlamlılığa ulaşabiliyor, küçük örneklemlerde ise testin gücü düşük. Bu yüzden yalnız teste güvenmek yetmiyor; sonucu klinik muhakemeyle birlikte değerlendirmek gerekiyor.
Liste bazlı silme: neden yetersiz?
SPSS'te çoğu analiz varsayılan olarak liste bazlı silme (listwise deletion) uyguluyor. Basit ve MCAR altında yansız. Ama ciddi güç kaybı var. 10 değişkenin her birinde bağımsız %5 eksiklik varsa, tam gözlem oranı 0,95^10 = %60. Gözlemlerin %40'ı kaybediliyor.
İkili silme (pairwise deletion) daha fazla veri kullanıyor ama farklı analizler farklı örneklemler üzerinde yürüyor. Tutarsız sonuçlar çıkabiliyor, korelasyon matrisi pozitif belirli olmayabiliyor.
Uyarı
Ortalama ile doldurma (mean substitution) yöntemini kesinlikle önermiyoruz. Değişkenin varyansını sistematik olarak küçültüyor, değişkenler arası korelasyonları zayıflatıyor, standart hataları yapay biçimde daraltıyor. Modern istatistik pratiğinde kabul edilebilir bir yöntem olarak görülmüyor (Schafer ve Graham, 2002). LOCF (Last Observation Carried Forward) da benzer sorunlar taşıyor.
Çoklu imputasyon: en dayanıklı çözüm
Yöntemin kendisi kadar kurulumu da belirleyici. İmputasyon modeline hangi değişkenlerin gireceğini, sağkalımda hangi zaman teriminin kullanılacağını ve hangi tanı kontrollerinin şart olduğunu çoklu imputasyon model kurulumu yazımızda ele aldık.
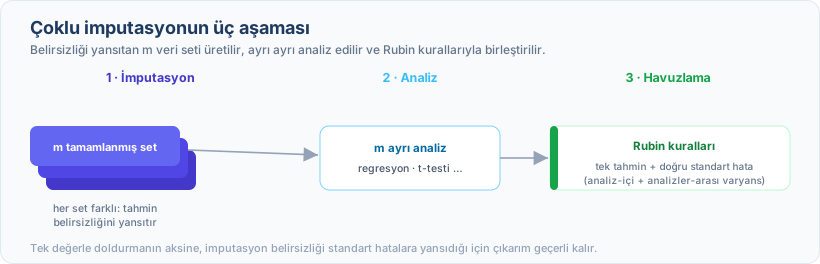
Rubin'in 1987'de önerdiği çoklu imputasyon (MI) üç aşamadan oluşuyor. Birinci aşamada eksik değerler için m adet tamamlanmış veri seti oluşturuluyor; her biri farklı, çünkü tahmin belirsizliğini yansıtıyor. İkinci aşamada ilgilendiğiniz analiz (regresyon, t-testi ya da başka bir analiz) her veri setinde ayrı ayrı çalıştırılıyor. Üçüncü aşamada Rubin kuralları m adet sonucu birleştiriyor. Havuzlanmış tahmin, m sonucun ortalaması; toplam varyans ise hem analiz içi hem analizler arası varyansı içeriyor. Böylece imputasyon belirsizliği standart hatalara yansıyor.
MICE (Multivariate Imputation by Chained Equations, yani zincirleme denklemlerle çok değişkenli imputasyon) yaygın kullanılan bir MI algoritması. Her eksik değişken için ayrı bir model tanımlıyor; sürekli değişkenler için öngörücü ortalama eşleme (PMM), ikili değişkenler için lojistik regresyon, nominal değişkenler için multinomial lojistik kullanılabiliyor. R'deki mice paketi bu esnekliği sunuyor; SPSS'in modülü daha sınırlı, özellikle kategorik değişkenlerde.
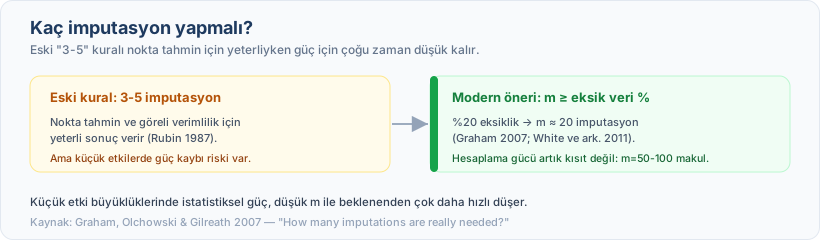
Kaç imputasyon yapılmalı? Eski "3-5" kuralı nokta tahminler ve göreli verimlilik için yeterli sonuç verir (Rubin 1987). Ancak Graham ve arkadaşlarının (2007) gösterdiği gibi, küçük etki büyüklüklerinde istatistiksel güç, düşük m ile beklenenden çok daha hızlı düşüyor. White ve arkadaşları (2011) ise m'nin en az tamamlanmamış vaka yüzdesi kadar seçilmesini öneriyor; vakaların %20'sinde en az bir değer eksikse en az 20 imputasyon gerekiyor. Hesaplama gücü artık kısıt olmadığından m=50 veya m=100 kullanmak makul.
FIML: İmputasyon yapmadan analiz
Full Information Maximum Likelihood (FIML, yani tam bilgi en çok olabilirlik), eksik değerleri doldurmak yerine gözlenen verilerin olabilirlik fonksiyonunu maksimize ederek parametre tahmini yapıyor. Her gözlem için mevcut tüm bilgi kullanılıyor ve standart hatalar da doğrudan hesaplanıyor.
FIML, yapısal eşitlik modelleri (SEM) ve çok düzeyli modellerde özellikle güçlü. Mplus, lavaan (R) ve Amos destekliyor. MAR varsayımı altında MI ile asimptotik olarak eşdeğer sonuçlar veriyor.
Genel regresyon ve t-testi gibi analizlerde MI daha esnek bir çerçeve sunarken, SEM gibi model bazlı analizlerde FIML daha doğal bir seçenek.
Duyarlılık analizi: MAR varsayımını test etmek
MAR altında imputasyon yapıyorsunuz ama gerçek mekanizma MNAR ise sonuçlar yanlı olabilir. Bu riski değerlendirmek için duyarlılık analizi gerekiyor.
Dönüm noktası (tipping point) analizi, ICH E9(R1)'in örnek verdiği yöntemlerden biri. İmputasyonla atanan değerlere sistematik bir sapma (delta) ekleniyor ve sonuçların hangi noktada anlamlılığını yitirdiği belirleniyor. Tedavi grubundaki eksik sonuç değerlerine delta=0, 1, 2, 3… eklenerek her senaryoda tedavi etkisi kontrol ediliyor. Dönüm noktası klinik olarak mantıksız bir düzeyde ise, sonuçlar MNAR'a karşı dayanıklı.
EMA'nın eksik veri kılavuzu ve EMA ile FDA'nın benimsediği ICH E9(R1), ruhsata esas (doğrulayıcı) çalışmalarda önceden planlanmış duyarlılık analizi bekliyor. Eksiklik ihmal edilemeyecek düzeydeyse hakemler de bunu arayabiliyor. En sade yaklaşım olarak tam vaka (complete case) analizi ile MI sonuçlarını karşılaştırarak tutarlılığı göstermek bile hiç yapmamaktan çok daha güçlü.
Raporlama
Eksik veri analizinin doğru raporlanması, hakem sürecindeki eleştirileri önlemenin etkili yollarından biri. STROBE (madde 12c, 14b) ve CONSORT 2025 (madde 21c) eksik verinin raporlanmasını, RECORD (madde 19.1) ise sınırlılıklarda tartışılmasını istiyor; ayrıntılı öneriler için Sterne ve arkadaşlarının (2009) çalışmasına bakılabilir.
Yöntem bölümünde: eksiklik mekanizması varsayımı ve gerekçesi, uygulanan yöntem, kaç imputasyon yapıldığı, modele dâhil edilen değişkenler, duyarlılık analizi yaklaşımı ve kullanılan yazılım.
Sonuçlar bölümünde: her değişken için eksiklik oranı, Little's MCAR testi sonucu, MI/ML sonuçları (havuzlanmış tahminler), tam vaka analiziyle karşılaştırma ve duyarlılık analizi bulguları.
Örnek raporlama cümlesi: "Birincil sonuç değişkeninde %12,4 eksiklik gözlendi. Little's MCAR testi MCAR ile uyumsuz bulundu (χ²=34,2, sd=18, p=0,012). MAR varsayımı altında 20 tamamlanmış veri seti ile çoklu imputasyon uygulandı (MICE, PMM). Dönüm noktası yaklaşımıyla sonuçların delta=5 birime kadar dayanıklı olduğu gösterildi."
Türkiye'de eksik veri farkındalığı
Deneyimimizde Türkiye'deki tıp tezlerinin bir kısmında eksik veri sorununa hiç değinilmiyor ya da yalnızca "eksik veriler analiz dışı bırakıldı" deniyor. SPSS yaygın olarak kullanılıyor ama çoklu imputasyon modülü kategorik değişkenlerde sınırlı. R'deki mice paketi çok daha esnek bir ekosistem sunuyor.
Eksik veri stratejisini etik kurul başvurusunda, protokolün içinde belirtmek de yerinde olur.
Model İstatistik olarak eksik veri stratejisinin planlanmasından raporlanmasına kadar tüm sürece rehberlik ediyoruz. Dropout rate hesaplama yazımız katılımcı düzeyindeki kayıpları ele alıyor, buradaki konu ise değişken düzeyindeki eksiklikler; ikisi birbirini tamamlıyor. Doğru mekanizma değerlendirmesi, uygun imputasyon yöntemi ve şeffaf raporlama ile eksik veri sorunu yönetilebilir bir teknik ayrıntıya dönüşüyor.
Kullanılan kaynaklar
- Rubin DB. Inference and missing data. Biometrika. 1976;63(3):581-592. · DOI
- Rubin DB. Multiple Imputation for Nonresponse in Surveys. New York: John Wiley & Sons; 1987.
- Schafer JL, Graham JW. Missing data: our view of the state of the art. Psychological Methods. 2002;7(2):147-177. · PMID: 12090408
- Graham JW, Olchowski AE, Gilreath TD. How many imputations are really needed? Some practical clarifications of multiple imputation theory. Prevention Science. 2007;8(3):206-213. · DOI
- White IR, Royston P, Wood AM. Multiple imputation using chained equations: issues and guidance for practice. Statistics in Medicine. 2011;30(4):377-399. · DOI
- Sterne JAC, White IR, Carlin JB, Spratt M, Royston P, Kenward MG, Wood AM, Carpenter JR. Multiple imputation for missing data in epidemiological and clinical research: potential and pitfalls. BMJ. 2009;338:b2393. · DOI
- Jakobsen JC, Gluud C, Wetterslev J, Winkel P. When and how should multiple imputation be used for handling missing data in randomised clinical trials: a practical guide with flowcharts. BMC Med Res Methodol. 2017;17:162.
- European Medicines Agency. Guideline on Missing Data in Confirmatory Clinical Trials. EMA/CPMP/EWP/1776/99 Rev. 1; 2010.
- ICH E9(R1) Addendum on Estimands and Sensitivity Analysis in Clinical Trials (2019).
- Hopewell S, Chan AW, Collins GS, ve ark. CONSORT 2025 statement: updated guideline for reporting randomised trials. BMJ. 2025;389:e081123.
- Benchimol EI, Smeeth L, Guttmann A, ve ark. The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLoS Med. 2015;12(10):e1001885.