
Çok merkezli bir çalışmada beş merkezden 320 hastanın verisi toplandığında elinize ulaşan şey homojen bir veri seti değil, çoğu zaman bir yamalar toplamıdır. İlk merkez Excel gönderir, ikincisi PDF tarama, üçüncüsü el yazısı form; birinde hemoglobin g/dL, diğerinde g/L birimindedir; yaş bir yerde "52", başka yerde "50-55 arası" diye yazılmıştır; tarihler üç farklı biçimde gelir. Çok merkezli çalışmanın en zor kısmı veriyi toplamak değil, toplanan veriyi kullanılabilir hâle getirmektir. Bu yazı veri kaosunu önlemenin ve harmonizasyonu yönetmenin yollarına odaklanıyor; rol, SOP ve koordinasyon tarafını çok merkezli araştırma yönetimi yazımızda ele aldık.
Çok merkezli çalışma neden bu kadar zor?
Tasarımın çekici yanları bellidir. Örneklem hızla büyür, nadir hastalıklarda yeterli vakaya ulaşılır ve bulguların genellenebilirliği artar; hakemler ve dergiler de bu tasarıma genellikle olumlu bakar. Zorluk, her merkezin kendi düzenine alışkın olmasından doğar. Biri veriyi hastane bilgi sisteminden çeker, diğeri kâğıt dosyaya güvenir, üçüncüsü yalnızca kritik alanları doldurur, dördüncüsü "lazım olur" diye fazladan ayrıntı ekler, beşincisi üç ay gecikir.
Gerçekten çok merkezli olmalı mı?
Bu kararı vermeden önce gerçek maliyeti bilmek gerekir.
Tek merkezli ile çok merkezli: gerçek maliyet
Tek merkezli
- •Koordinasyon basit; tek ekip, tek sistem
- •Veri formatı homojen; tek standart
- •Tek etik kurul başvurusu yeterli
- •Örneklem sınırlı; nadir hastalıklarda yetersiz
- •Dış geçerlilik düşük; sonuçlar genellenemeyebilir
Çok merkezli
- •Koordinasyon karmaşık; her merkezin temposu ayrı
- •Veri uyumsuzluğu riski yüksek; harmonizasyon şart
- •Her merkezden ayrı kurum izni; süreç uzar
- •Örneklem büyük; nadir hastalıklarda da yeterli
- •Dış geçerlilik yüksek; farklı popülasyonları kapsar
Tabloya bakınca çok merkezli tasarım her zaman üstünmüş gibi görünebilir, ama öyle değildir. Koordinasyon kapasitesi yoksa iki merkez bile karmaşaya yol açabilir. Tek merkezli çalışmanın sınırları bilinerek yönetilebilir; çok merkezli çalışmanın koordinasyon sorunları ise bilinse bile zor yönetilir.
CRF olmadan veri toplamak: en pahalı kestirme
Vaka rapor formu (Case Report Form, CRF) yalnızca bir form değil, merkezler arasındaki ortak dildir. Hangi değişkenin nasıl girileceğini, hangi birimle ölçüleceğini, eksik verinin nasıl kodlanacağını ve "tanı tarihi"nin ne anlama geleceğini CRF belirler. CRF olmadan başlayan çok merkezli çalışmalarda sorunlar genellikle veri toplama aşamasında ortaya çıkar. "Tanı tarihi" ilk semptom mu, ilk başvuru mu, biyopsi mi, patoloji raporu mu? Bir merkez birincisini, diğeri sonuncusunu gönderir. Prospektif çalışmada CRF zorunludur, retrospektif çalışmada bile standart bir veri çıkarım şablonu gerekir; merkezlere "verileri gönderin" deyip serbest bırakırsanız beş farklı formatta beş farklı değişken seti alırsınız.
CRF tasarımında üç kural işe yarar. Serbest metin alanları en aza indirilir ve mümkün olan her yerde açılır menü kullanılır. Her alanın tam tanımını yazmak gerekir ("HbA1c" değil, "son 3 ay içindeki en güncel HbA1c değeri, % cinsinden"). Son olarak CRF'yi bir pilot çalışma kapsamında iki üç hasta üzerinde denemek şarttır; hangi alanın kafa karıştırdığını ancak bu deneme gösterir.
Birim karışıklıkları: sessiz katil
Bir merkez hemoglobini g/dL, diğeri g/L olarak gönderir; birinde 12,5, diğerinde 125 yazar. İkisi de doğrudur; ama birleştirme sırasında fark edilmezse bir merkezdeki tüm hastalar "kritik anemi" olarak kodlanır. Laboratuvar birim farkları çok merkezli çalışmaların en sinsi sorunlarındandır; yalnızca hemoglobinde değil, kreatinin, CRP ve troponin değerlerinde de cihaz ve birim farkları vardır. Çözüm basittir ama disiplin ister. Birimi CRF'de açıkça belirtmek, elektronik veri toplama sistemine (EDC) aralık kontrolü koymak ve veri geldiğinde ilk iş olarak birim tutarlılığını denetlemek bu disiplinin parçasıdır. Farklı laboratuvar yöntemleri söz konusuysa dönüşüm formüllerini uygulamak, formül yoksa durumu sınırlılık olarak belirtmek gerekir.
Harmonizasyon: asıl iş burada başlıyor
Tüm merkezlerden veri geldiğinde asıl mesai başlar; farklı format ve birimler ancak ortak CRF/EDC ve harmonizasyonla birleşir.
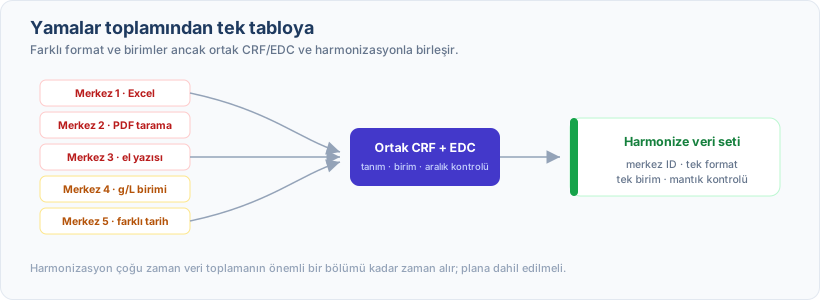
Birleştirmede merkez kimliği (ID) vazgeçilmezdir; hangi hastanın hangi merkezden geldiği her satırda görünmelidir. Tarih, sayısal değer ve kategorik değişkenler tek bir biçimde buluşmalıdır. Eksik veri için bütün merkezlerde aynı kodlamayı kullanmak, boş hücre yerine eksikliğin nedenini ayıran ayrı kodlar (ör. ölçülmemiş, ulaşılamıyor) tanımlamak gerekir. Mantık kontrolleri şarttır. Tanı tarihi doğum tarihinden önce olamaz; 48 saati aşan bir ameliyat süresi ya da 25 g/dL hemoglobin gibi değerler de akla yatkın değildir. Bu tür değerler veri girişi hatasına ya da birim karışıklığına işaret eder. Şüpheli veri ilgili merkeze gönderilip teyit edilir. Bu süreç genellikle veri toplama süresinin önemli bir bölümü kadar zaman alır; bu yüzden harmonizasyona ciddi bir pay ayırmayan takvim sıkıntı yaratır.
Geçen yıl beş merkezli retrospektif bir çalışmada 180 hasta verisi topladık; CRF vardı. Yine de bir merkez tüm laboratuvar değerlerini tanı anından gönderdi, biz tedavi öncesi son değerleri istemiştik; başka bir merkez takip süresini "tanı-son kontrol" olarak hesaplamış, biz "tedavi-son kontrol" istemiştik; üçüncü merkez yalnızca hayatta kalan hastaların verisini göndermiş, ölen hastaları "bu çalışmaya dâhil değil" saymıştı. Sonuçta iki ay ek süre, kırk küsur e-posta ve üç düzeltme turu gerekti. Bu deneyim, ne kadar ayrıntılı olursa olsun CRF'nin tek başına yetmediğini, her merkezin veri giriş sorumlusunun birebir eğitilmesi gerektiğini gösterdi.
Merkez etkisi: analizi karmaşıklaştıran gerçek
Farklı merkezlerdeki hasta profilleri, tedavi yaklaşımları ve ölçüm standartları birbirinden ayrışır; bu "merkez etkisi" modele alınmazsa hakem sorar. Merkez etkisinin örneklem hesabına yansıması ise tasarıma bağlıdır. Merkezler bütünüyle tek bir gruba atanıyorsa (küme tasarımı) kümeleme, tasarım etkisi (DEFF) yoluyla gereken hasta sayısını artırır.
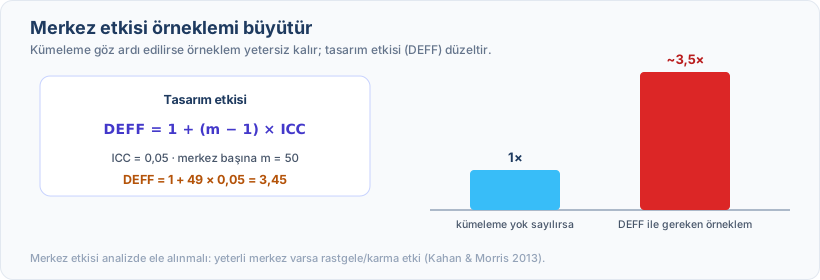
Sınıf içi korelasyon katsayısı (ICC) aynı merkezdeki bireylerin birbirine ne kadar benzediğini ölçer. Çoğu zaman 0,05'in altında kalır, ama sonuca ve alana göre 0,10'u aştığı da olur (Adams ve ark. 2004; Cook ve ark. 2012). Küme tasarımında ICC = 0,05 ve merkez başına 50 hasta ile tasarım etkisi 3,45 çıkar; yani kümeleme göz ardı edilen bir hesaba göre yaklaşık 3,5 kat daha fazla hasta gerekir. Sürekli sonlanımlı çalışmalarda karşılaştırılan gruplar her merkezde benzer oranlarda yer alıyorsa (örneğin merkeze göre tabakalı bireysel randomizasyonda) durum tersine döner; merkezi analize katmak gücü artırır ve gereken örneklem küçülebilir. Aynı çerçevede, gruplar merkezlere çok farklı oranlarda dağılmışsa güç kaybı yine söz konusudur (Vierron ve Giraudeau 2009).
Merkez etkisini modellemenin iki yolu vardır. Merkez modele sabit etki olarak eklenebilir ya da rastgele etki (karma model) olarak modellenebilir. Kahan ve Morris'in (2013) sürekli sonlanımlı çok merkezli denemeler için yaptığı 378 senaryoluk simülasyonunda rastgele etki modelleri tüm senaryolarda sabit etki kadar iyi ya da daha iyi sonuç verdi; merkez başına hasta sayısı az olduğunda (kabaca 10 ve altı) güç ve kesinlik kazandırdı. Yazarlar bu yüzden merkez başına hasta sayısı azsa ya da merkez içinde tedavi dağılımı dengesiz olabilecekse rastgele etki modellerinin uygulamada daha sık kullanılmasını öneriyor. Rastgele etki çıkarımı büyük örneklem varsayımına dayandığından örneklem, özellikle de merkez sayısı küçük olduğunda serbestlik derecesi düzeltmesi gerekir; yazarlar bu düzeltmeyle nominal kapsama oranının korunduğunu bildiriyor. Merkez sayısının az olduğu 5 ve 10 merkezli senaryolarda ise iki yaklaşım benzer sonuç verdi. Merkez başına hasta sayısı dengesizse (bir merkezde 120, diğerinde 15) bu dengesizlik de analizde dikkate alınmalı.
Başlangıç (baseline) özelliklerini merkez bazında tabloda göstermek zorunlu bir adım gibi düşünülmeli; bir merkezde ortalama yaş 45, diğerinde 68 ise sonuçları doğrudan karşılaştırmak yanıltıcıdır. Merkezler tek tek çıkarılarak yapılan duyarlılık analizi de bulguların tek bir merkeze dayanıp dayanmadığını gösterir.
Makaleye nasıl yansıtılır?
Yöntem bölümünde kaç merkezin katıldığı, her merkezden kaç hasta dâhil edildiği, veri toplama sürecinin nasıl standartlaştırıldığı, CRF kullanılıp kullanılmadığı ve merkez etkisinin analizde nasıl ele alındığı belirtilmeli. Sonuçlar bölümünde merkez bazlı başlangıç tablosu verilmeli; merkez etkisi anlamlıysa duyarlılık analizi yapılıp sonuçların merkezler tek tek çıkarıldığında nasıl değiştiği gösterilmeli. Tartışma bölümünde harmonizasyon sürecini, veri uyumsuzluk oranını ve bunların sonuçlara olası etkisini sınırlılık olarak yazmak hakeme güven verir.
Çok merkezli çalışma, doğru planlama ve titiz koordinasyonla değerli sonuçlar üretir; "veri toplayıp birleştirelim" yaklaşımıyla ise zamanın önemli bir bölümü harmonizasyona gider. Model İstatistik olarak çok merkezli çalışmaların veri yönetimi ve harmonizasyon sürecinde araştırmacıya rehberlik ediyoruz. En önemli önerimiz, bu planlamanın çalışma başlamadan yapılmasıdır.
Not: Buradaki ICC, DEFF ve örneklem değerleri kavramı göstermek için seçilmiş örneklerdir; gerçek değerler çalışmanın verisine ve merkez yapısına göre değişir.
Kullanılan kaynaklar
- Kahan BC, Morris TP. Analysis of multicentre trials with continuous outcomes: when and how should we account for centre effects? Statistics in Medicine. 2013;32(7):1136-1149. · DOI
- Harris PA, Taylor R, Thielke R, Payne J, Gonzalez N, Conde JG. Research electronic data capture (REDCap)—a metadata-driven methodology and workflow process for providing translational research informatics support. Journal of Biomedical Informatics. 2009;42(2):377-381. · DOI
- Vierron E, Giraudeau B. Design effect in multicenter studies: gain or loss of power? BMC Medical Research Methodology. 2009;9:39. doi:10.1186/1471-2288-9-39
- Adams G, Gulliford MC, Ukoumunne OC, Eldridge S, Chinn S, Campbell MJ. Patterns of intra-cluster correlation from primary care research to inform study design and analysis. Journal of Clinical Epidemiology. 2004;57(8):785-794. doi:10.1016/j.jclinepi.2003.12.013
- Cook JA, Bruckner T, MacLennan GS, Seiler CM. Clustering in surgical trials: database of intracluster correlations. Trials. 2012;13:2. doi:10.1186/1745-6215-13-2