
Bir çalışma "anlamlı bir fark bulunamadı" dediğinde iki olasılık var: ya gerçekten fark yoktur, ya da fark vardır ama çalışma onu görecek kadar güçlü değildir. Bu ikisini ayırmanın yolu güç analizinden geçiyor; güç analizi, bir araştırmanın var olan gerçek bir etkiyi istatistiksel olarak yakalayabilme olasılığını önceden hesaplayan çerçeve.
Güç analizinin neden zorunlu olduğunu ve etik kurul bağlamını güç analizi neden gerekli yazımız ayrıca ele alıyor.
Güç analizi tam olarak neyi ölçüyor?
Güç analizi, bir araştırmanın gerçek bir etkiyi veya farkı istatistiksel olarak tespit edebilme olasılığını belirleyen matematiksel bir hesaplama. Daha somut bir ifadeyle, gerçekten bir fark varsa araştırmanın bu farkı yakalama şansı nedir?
Bu şans %50 ise, yazı-tura atmakla aynı işi yapıyorsunuz demektir. %80 ise makul bir güvenle sonuç elde ediliyor. %95 ise çok güçlü bir çalışma tasarlanmış olur ama bunun için çok daha büyük örneklem gerekiyor.
Güç analizi dört parametre arasındaki matematiksel ilişkiye dayanıyor. Bu dört parametreden üçü bilindiğinde dördüncüsü hesaplanabiliyor. En yaygın kullanım, ilk üçünü belirleyip örneklem büyüklüğünü hesaplamak.
Dört parametre birbirini nasıl belirliyor?
| Parametre | Sembol | Tanım | Yaygın değer |
|---|---|---|---|
| Anlamlılık düzeyi | α | Tip I hata olasılığı | 0,05 |
| İstatistiksel güç | 1 − β | Gerçek bir etkiyi doğru tespit etme olasılığı | 0,80 veya 0,90 |
| Etki büyüklüğü | d, r, f, OR | Gruplar arasındaki farkın büyüklüğü | Çalışmaya özgü |
| Örneklem büyüklüğü | n | Katılımcı sayısı | Hesaplanan değer |
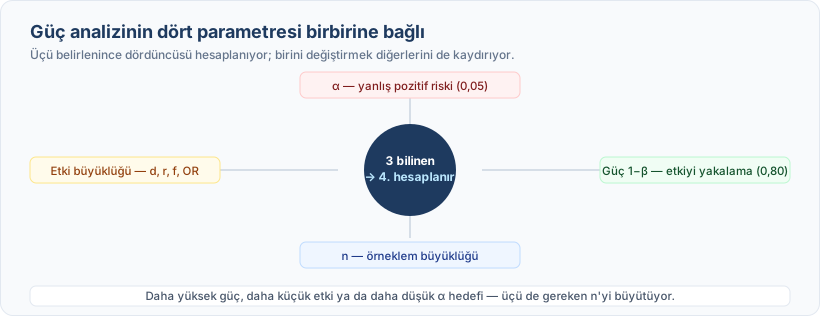
Bu dört parametre birbirine bağlı; birini değiştirdiğinizde diğer üçünden en az biri etkileniyor. Bu bağlantı güç analizinin temeli.
Anlamlılık düzeyi (α)
α, yanlış pozitif sonuç elde etme olasılığını temsil ediyor; yani gerçekte fark yokken fark bulunduğunu sanma riski. Tıbbi araştırmalarda gelenek olarak α = 0,05 kullanılıyor; bu, %5 yanlış pozitif riskinin kabul edildiği anlamına geliyor. Neden 0,05? Tarihsel bir uzlaşma. Bazen 0,01 (daha tutucu), bazen 0,10 (daha keşfedici) kullanılıyor ama standart 0,05.
Çoklu karşılaştırma yapıldığında (örneğin 10 test birden) α düzeyinin düzeltilmesi gerekiyor; en bilinen yöntem olan Bonferroni düzeltmesinde 10 test için α = 0,05/10 = 0,005 oluyor. Aksi hâlde şans eseri anlamlı sonuç bulma olasılığı artıyor.
İstatistiksel güç (1 − β)
Güç, araştırmanın gerçek bir etkiyi yakalama olasılığı anlamına geliyor ve Güç = 1 − β ile ifade ediliyor. β, Tip II hata oranını, yani gerçekte var olan bir farkı kaçırma olasılığını temsil ediyor.
Standart eşik %80, yani β = 0,20; gerçek fark varsayılan etki büyüklüğü kadarsa uzun vadede 100 çalışmadan 80'i bunu yakalar, 20'si kaçırır. Tekrarı zor çalışmalarda %90 güç hedeflenebiliyor (ICH E9); ancak %90 güç önemli ölçüde daha büyük örneklem gerektiriyor.
Etki büyüklüğü
Etki büyüklüğü, gruplar arasındaki farkın veya değişkenler arasındaki ilişkinin pratikte ne kadar anlamlı olduğunu gösteren standartlaştırılmış bir ölçü ve güç analizinin en kritik, belirlemesi en zor parametresi. Zorluk, çalışma yapılmadan önce "ne kadar bir fark bekliyorsunuz?" sorusunu yanıtlamayı gerektirmesinden geliyor.
| Test türü | Etki büyüklüğü ölçüsü | Küçük | Orta | Büyük |
|---|---|---|---|---|
| t-testi | Cohen's d | 0,20 | 0,50 | 0,80 |
| ANOVA | Cohen's f | 0,10 | 0,25 | 0,40 |
| Korelasyon | Pearson r | 0,10 | 0,30 | 0,50 |
| Ki-kare | Cohen's w | 0,10 | 0,30 | 0,50 |
| Lojistik regresyon | Odds oranı (OR; Rosenthal, 1996) | 1,5 | 2,5 | 4,0 |
Cohen'in küçük-orta-büyük sınıflandırması bir rehber ama son çare olarak kullanılmalı (Cohen, 1988; Lakens, 2013). Etki büyüklüğünün dayanağı klinik olarak anlamlı en küçük fark (MCID) ya da benzer popülasyondaki literatür (meta-analiz veya benzer çalışmalar) olmalı; pilot çalışma verisi bu seçimi yalnızca destekler. Etki büyüklüğü hesaplama yöntemleri yazımızda Cohen's d, Hedges' g, odds oranı, NNT ve diğer ölçüleri ele aldık.
Örneklem büyüklüğü (n)
Örneklem büyüklüğü, güç analizinin çoğu zaman asıl çıktısı; diğer üç parametre belirlendikten sonra gereken minimum katılımcı sayısı hesaplanıyor. Ama bu "minimum" sayının beklenen kayıp oranına göre büyütülmesi şart; çünkü prospektif çalışmalarda takip kaybı, eksik veri ve protokol ihlali nedeniyle katılımcı kaybı yaşanıyor.
Düzeltme formülü basit: n_düzeltilmiş = n_hesaplanan / (1 − kayıp oranı). %15 kayıp bekleniyorsa ve güç analizi 64 katılımcı öneriyorsa: 64 / 0,85 ≈ 76 katılımcı. Örneklem büyüklüğü hesaplama yazımızda bu hesaplamaların pratiğini adım adım anlattık.
Tip I ve Tip II hata ne anlama geliyor?
Güç analizini tam kavramak için Tip I ve Tip II hataları net anlamak gerekiyor; bu iki hata türü, istatistiksel karar vermenin kaçınılmaz riskleri.
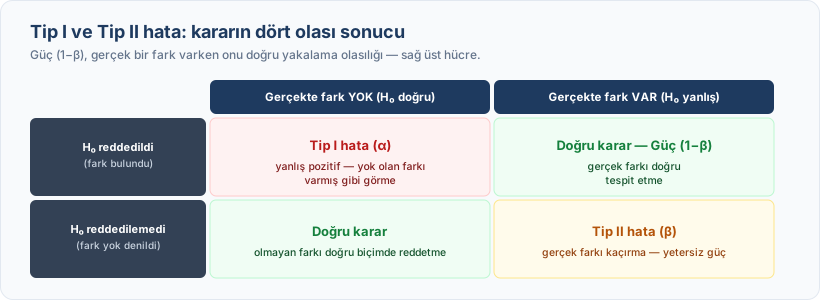
Tip I hata: Gerçekte fark yokken fark varmış gibi sonuç elde etme; etkisiz bir ilacın etkili göründüğü durum. α = 0,05 demek, bu riski %5 ile sınırlamak demek.
Tip II hata: Gerçekte fark varken bunu tespit edememe; etkili bir ilacın etkisiz göründüğü durum. β = 0,20 (güç = 0,80) demek, %20 kaçırma riski demek.
Tıbbi araştırmalarda her iki hatanın da ciddi sonuçları var; Tip I hata etkisiz bir tedavinin etkili sanılmasına, Tip II hata etkili bir tedavinin gözden kaçırılmasına yol açabiliyor.
Akademik Not
Bir araştırmanın "istatistiksel olarak anlamsız" sonuç vermesi, gerçekte fark olmadığı anlamına gelmiyor. Yetersiz güçle yürütülen çalışmalarda Tip II hata riski yüksektir ve düşük güç, anlamlı çıkan sonuçların bile güvenilirliğini azaltır (Button ve ark., 2013). Bu nedenle "anlamsız" sonuçları yorumlarken güven aralıklarına ve etki büyüklüğüne bakmak kritik. p değeri anlamsız çıktığında yazımızda bu durumu ele aldık.
Hangi güç analizi türü ne zaman kullanılıyor?
G*Power beş tür güç analizi sunuyor: a priori, post hoc, uzlaşmalı, duyarlılık ve ölçüt (criterion). Hangisinin uygun olduğu araştırmanın hangi aşamasında olduğunuza bağlı.
Hangi güç analizi türü?
A priori: Veri toplama öncesinde örneklem büyüklüğü hesaplamak için; altın standart. Etik kurullar ve hakemler bunu görmek istiyor. Bu hesabı doğru zamanda yapabilmek, biyoistatistikçiyi tasarım aşamasında dahil etmeye bağlı.
Post-hoc: Çalışma tamamlandıktan sonra gücü hesaplamak için. Gözlenen etki büyüklüğüyle hesaplanan güç (gözlenen ya da retrospektif güç), gözlenen p değerinin doğrudan bir fonksiyonu olduğu için yeni bilgi taşımıyor ve döngüsel bir hesaplama olarak eleştiriliyor; G*Power yazarları ise "post hoc" adını önceden belirlenen etki büyüklüğüyle yapılan hesaba da veriyor. Post-hoc güç analizi yazımız bu tuzağı ayrıntılı ele alıyor.
Duyarlılık (sensitivity): Örneklem sabit olduğunda (örneğin retrospektif çalışma) tespit edilebilir minimum etki büyüklüğünü hesaplamak için. A priori analizin mümkün olmadığı durumlarda en uygun yaklaşım.
Ölçüt (criterion): Güç, etki büyüklüğü ve örneklem bilindiğinde α düzeyini hesaplamak için; β'yı sınırlamanın α'yı sınırlamaktan daha önemli olduğu durumlarda (örneğin model uyum testlerinde) kullanılıyor.
Uzlaşmalı (compromise): Örneklem ve etki büyüklüğü sabitken α ve β'yı, önceden seçilen β/α oranına göre birlikte belirlemek için (Faul ve ark., 2007).
Örnekler üzerinde nasıl görünüyor?
Örnek 1: Bağımsız iki grup t-testi. Yeni bir ilacın kan basıncına etkisi test edilecek. Literatürde benzer çalışmalar Cohen's d = 0,5 civarında etki bildirmiş. α = 0,05, güç = 0,80 ile her grupta 64, toplam 128 katılımcı gerekiyor. %15 kayıp hesaba katılınca: 64 / 0,85 = 75,3; yukarı yuvarlanınca grup başına 76, toplam 152 katılımcı.
Örnek 2: Korelasyon analizi. Yaş ile kemik mineral yoğunluğu arasındaki ilişki araştırılıyor. Beklenen korelasyon r = 0,3. α = 0,05, güç = 0,80 ile toplam 84 kişi gerekiyor.
Örnek 3: Üç grubun karşılaştırılması (ANOVA). İlaç A, İlaç B ve plaseboyla Cohen's f = 0,25 (orta etki), α = 0,05 ve güç = 0,80 için 3 grupta toplam 159 kişi gerekiyor (her grupta 53).
Bu örnekler G*Power ile hesaplanıyor; G*Power adım adım rehberimizde her örneği ekran ekran gösterdik. Hızlı bir tahmin için örneklem hesaplama aracını da kullanabilirsiniz.
Sonuç nasıl raporlanıyor?
Güç analizi hem etik kurul protokolünde hem de makale yöntem bölümünde raporlanıyor. Raporda yer alması gereken bilgiler:
- Kullanılan istatistiksel test
- Etki büyüklüğü değeri ve dayanağı (MCID ya da literatür; varsa pilottan alınan yardımcı parametreler)
- Anlamlılık düzeyi (α)
- Hedeflenen güç
- Hesaplanan örneklem büyüklüğü
- Kayıp oranı ve düzeltilmiş örneklem
- Kullanılan yazılım ve sürümü
Örnek raporlama cümlesi: "Birincil sonuç ölçütümüz olan HbA1c düzeyindeki farkı değerlendirmek üzere bağımsız örneklem t-testi için a priori güç analizi yapılmıştır. Smith ve ark. (2022) tarafından bildirilen 0,65 standart sapma birimlik etki büyüklüğü (Cohen's d), iki yönlü α = 0,05 anlamlılık düzeyi ve %80 güç hedefi esas alındığında her grup için minimum 39 katılımcı gerektiği hesaplanmıştır (G*Power 3.1.9.7). %15 kayıp oranı göz önüne alınarak toplam 92 katılımcı hedeflenmiştir."
Bu format, hem etik kurul üyelerinin hem de hakemlerin örneklem büyüklüğünün bilimsel temelini kolayca değerlendirmesini sağlıyor.
Pratikte nelere dikkat ediliyor?
Etki büyüklüğünün dayanağı önceden belirleniyor: klinik olarak anlamlı en küçük fark (MCID) ya da benzer popülasyondaki literatür (önce meta-analizler, yoksa benzer çalışmalar). Pilot çalışma standart sapma gibi yardımcı parametrelerin tahminine katkı verir, etki büyüklüğünü tek başına belirlemez. Cohen sınıflandırması ancak hiçbir kaynak yoksa ve gerekçelendirilerek kullanılıyor.
Birincil sonuç ölçütü esas alınıyor. Güç analizi birincil sonuç üzerinden yapılıyor; ikincil sonuçlar için ayrı analiz zorunlu değil ama çalışmanın bu sonuçlar için yeterli güçte olmayabileceğini belirtmek gerekiyor.
Belirsizlik varsa senaryo tablosu ekleniyor. Etki büyüklüğü tahmini belirsizse, farklı etki büyüklükleri için gereken örneklemi bir tablo olarak sunmak hakemlerin güvenini artırıyor.
Biyoistatistikçi erken aşamada dâhil oluyor. Güç analizi yalnızca yazılıma parametre girmek değil; doğru testin seçimi, etki büyüklüğünün anlamlı tahmini ve sonuçların yorumu uzmanlık gerektiriyor.
Model İstatistik olarak güç analizi sürecinde etki büyüklüğü tahmininden yazılım seçimine, hesaplamadan raporlamaya kadar araştırmacıya rehberlik ediyoruz.
Not: Buradaki eşik değerler (α = 0,05, güç 0,80) ve Cohen sınıflandırması yaygın uzlaşılardır, mutlak kural değildir. Örneklem kararı çalışmanın klinik bağlamına, birincil sonuç ölçütüne ve alanın standartlarına göre veriliyor.
Kullanılan kaynaklar
- Cohen J. A power primer. Psychol Bull. 1992;112(1):155-9. PMID 19565683 · DOI
- Cohen J. Statistical Power Analysis for the Behavioral Sciences. 2nd ed. Hillsdale, NJ: Lawrence Erlbaum; 1988.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91. PMID 17695343 · DOI
- Button KS, Ioannidis JPA, Mokrysz C, ve ark. Power failure: why small sample size undermines the reliability of neuroscience. Nat Rev Neurosci. 2013;14(5):365-76. PMID 23571845 · DOI
- Rosenthal JA. Qualitative descriptors of strength of association and effect size. J Soc Serv Res. 1996;21(4):37-59. doi:10.1300/J079v21n04_02
- Lakens D. Calculating and reporting effect sizes to facilitate cumulative science: a practical primer for t-tests and ANOVAs. Front Psychol. 2013;4:863. PMC3840331
- ICH E9. Statistical Principles for Clinical Trials, 1998, §3.5.