
Aylarca veri toplayıp analizi çalıştırdıktan sonra p = 0,12 görmek, çoğu araştırmacıda "bunca emek boşa mı gitti?" hissi uyandırıyor. Oysa istatistiksel olarak anlamsız bir sonuç, verinin değersiz olduğu anlamına gelmiyor; doğru okunduğunda beklenenden fazlasını söyleyebiliyor. Anahtar, p değerinin gerçekte ne dediğini ve ne demediğini ayırt etmek.
p > 0,05 aslında ne diyor?
p değeri 0,05'in üstünde çıktığında istatistiğin söylediği tek şey, eldeki verinin gruplar arasında fark olduğunu gösterecek kadar güçlü bir kanıt sunmadığıdır. "Fark yok" demiyor, "kanıt yetmedi" diyor ve bu ikisi birbirinden çok farklı. Altman ve Bland'ın (1995) meşhur ifadesiyle, "kanıtın yokluğu, yokluğun kanıtı değildir."
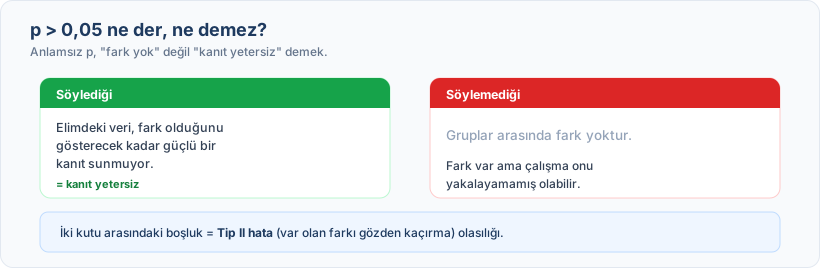
Karanlık bir odada fil arıyorsunuz, el yordamıyla dolaştınız ama file dokunmadınız. Bu "odada fil yok" mu demek, yoksa "ışık yoktu, yeterince bakamadım" mı? Burada iki farklı hata riski var: Tip I hata, olmayan bir farkı varmış gibi görmek (bunu alfa düzeyiyle kontrol ediyoruz); Tip II hata ise var olan bir farkı gözden kaçırmak. p > 0,05 çıktığında akla gelmesi gereken ilk soru, Tip II hata yapılıp yapılmadığı. Fark gerçekten var ama çalışma onu yakalayacak güçte değil miydi? Bu sorunun yanıtı etki büyüklüğünde ve güven aralığında saklı.
Makalede "gruplar arasında fark yoktur" yazmak, hakemlerin gözünde istatistiksel bir hata sayılıyor. Doğru ifade "istatistiksel olarak anlamlı fark saptanmamıştır" biçiminde; küçük bir ayrıntı gibi görünse de deneyimimizde hakemler bu farkı ciddiye alıyor. Eşdeğerliği göstermek ise baştan buna göre kurulmuş bir tasarım ve örneklem hesabı gerektirir; bunu tedavi eşdeğerliği yazımızda ele aldık.
Anlamsız p sonrası üç tuzak
p anlamlı çıkmadığında birkaç yaygın refleks ortaya çıkıyor; danışanlarımızda da sık gördüğümüz durumlar bunlar.
Alt grup avı. Genel sonuç anlamsız çıkınca "kadınlarda ayrı bakalım, 50 yaş üstünde ayrı bakalım, diyabetli grupta ayrı bakalım" arayışı başlıyor. Yeterince alt gruba bakıldığında bir yerden anlamlılık çıkabiliyor, ama bu sonuç gerçek bir bulgudan çok istatistiksel gürültü olabilir. Örneğin 200 kişilik bir çalışmada 8 farklı alt grup karşılaştırması yapıldığında, tamamen rastgele bile olsa en az birinden anlamlı sonuç çıkma olasılığı %34'e ulaşıyor (1 − 0,95⁸, testler birbirinden bağımsızsa). Alt grup analizi gerçekten gerekliyse, önceden protokole yazılmış olması ve çoklu karşılaştırma düzeltmesi uygulanması şart.
Seçici uç değer çıkarma. "Şu iki hastayı çıkarınca p = 0,04 oluyor" mantığı cazip gelebiliyor. Ama önceden tanımlanmış bir uç değer protokolü yoksa bu yola girmemek çok daha sağlıklı; sonuca bakıp geriye dönük veri temizliği yapmak, hakemler için ciddi bir kırmızı bayrak.
Hipotezi sonradan değiştirmek. Birincil sonuç ölçütü anlamsız çıkınca ikincil bir ölçütü ana hipotezmiş gibi sunmaya HARKing (Hypothesizing After the Results are Known) deniyor ve bilimsel dürüstlükle arasındaki çizgi çok ince. Bu üç tuzağın herhangi biri, p = 0,12'den çok daha büyük bir kariyer riski taşıyor.
Etki büyüklüğü neden daha çok şey anlatıyor
p değeri yalnızca "var mı yok mu" sorusuna yanıt veriyor; etkinin klinik olarak önemli mi yoksa ihmal edilebilir mi olduğunu söylemiyor. Bunun için etki büyüklüğü hesaplamak gerekiyor; Sullivan ve Feinn'in (2012) vurguladığı gibi, sonucun pratik önemini p değil etki büyüklüğü ortaya koyuyor.
Somut bir örnekte yeni bir ilaç, kan basıncını kontrol grubuna göre ortalama 8 mmHg daha fazla düşürmüş ama p = 0,12 çıkmış. Grup başına 14 hasta ve yaklaşık 13 mmHg standart sapmayla bu fark Cohen's d ≈ 0,6'ya karşılık geliyor; ancak farkın %95 güven aralığı kabaca −2 ile 18 mmHg arasında. Aralık hem etkisizlikle hem de klinik olarak önemli bir düşüşle uyumlu; sonuç ilacın etkisiz olduğunu göstermiyor, etkili olduğunu da kanıtlamıyor. Belirsizliği gösteren, gözlenen etkiden hesaplanan güç değil, güven aralığının genişliği.
Böyle bir durumda "ilaç etkisizdir" yazmak doğru değil. "İlaç grubunda kan basıncındaki düşüş kontrol grubuna göre ortalama 8 mmHg daha fazlaydı (%95 güven aralığı −2 ile 18 mmHg; p = 0,12); bu veriyle ilacın etkisi ne dışlanabilir ne de doğrulanabilir" çok daha isabetli bir ifade, çünkü sonucu olduğundan ne güçlü ne zayıf gösteriyor.
Güven aralığı, p'nin söylemediğini söylüyor
ICMJE önerileri, yalnız p değerine dayanılmamasını, mümkün olduğunda da bulguların güven aralığıyla verilmesini istiyor; birçok dergi de bu önerileri benimsiyor. Aşağıdaki iki örnek, aynı p > 0,05'in neden iki farklı hikâye anlatabildiğini gösteriyor:
Aynı p > 0,05, farklı hikâyeler
Sıfırı kıl payı içeriyor, ama aralığın büyük kısmı kayda değer bir etki yönünde. Veri klinik olarak önemli bir etkiyle uyumlu, ama bunu kanıtlamıyor.
Nokta tahmini küçük, ama aralık −4,1 ile 5,7 arasında. Aralık, klinik olarak önemli kabul edilen farkı iki yönde de dışlıyorsa ihmal edilebilir bir farktan söz edilebilir; dışlamıyorsa sonuç belirsiz.
İkisinde de p > 0,05, ama güven aralıkları farklı şeyler söylüyor; p değeri tek başına bu farkı gösteremiyor.
Post-hoc güç analizi yanılgısı
"Gücümüz düşükmüş, o yüzden anlamsız çıktı" diyerek post-hoc güç analizi yapıp tartışmaya koymak yaygın bir tercih. Ama gözlenen güç, p değerinin matematiksel bir dönüşümünden ibaret; p anlamsız çıkmışsa gözlenen güç zaten düşük çıkacaktır; yeni bir bilgi vermez, bilineni farklı bir sayıyla tekrarlar. Gelecek çalışmanın örneklemini klinik olarak anlamlı en küçük farka ya da güven aralığının makul ucuna ve literatüre göre hesaplamak çok daha değerli; küçük bir çalışmanın gözlenen etkisi ise tek başına dayanak olmamalı, çünkü bu tahminin kesinliği düşük ve güven aralığı hem önemsiz hem büyük etkilerle uyumlu olabiliyor (Lakens, 2013).
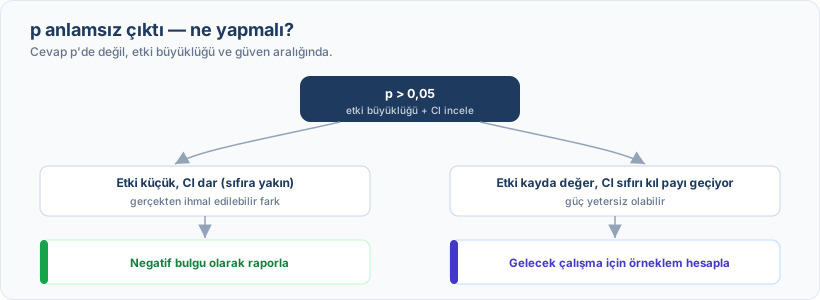
Bu ileriye dönük örneklem hesabı, tartışma bölümünde gerçekten yararlı bir bilgi; deneyimimizde hakemler de bunu görmek istiyor. Güç analizi kavramını daha yakından incelemek isterseniz o yazıya göz atabilirsiniz.
Negatif sonucu yayına hazırlamak
Negatif sonuçlu bir çalışmayı yayımlanabilir kılan şey, raporlama kalitesi. Sonuçlar bölümünde test istatistiği, p değeri, etki büyüklüğü ve güven aralığını birlikte vermek gerekiyor; "anlamsız çıktı" deyip geçmek yerine "İki grup arasında ortalama fark 3,4 birim olup (%95 GA −1,2, 8,0; p = 0,14; Cohen's d = 0,32) istatistiksel olarak anlamlı bulunmamıştır." gibi bir formülasyon çok daha güçlü bir izlenim bırakıyor. Tartışma bölümünde güven aralığının klinik anlamını, örneklem sınırlılığını ve gelecek çalışmalar için gereken örneklemi ele almak; negatif sonucu bir eksiklik olarak değil bir bulgu olarak konumlandırmak hem daha doğru hem de hakemler üzerinde daha olumlu. Dergi seçiminde PLOS ONE, BMJ Open ve Trials negatif sonuçlara açık dergiler arasında; Registered Reports formatında ise protokol önceden kabul edildiği için, kayıtlı protokole uyulduğu sürece makale sonuçtan bağımsız yayımlanabiliyor. Tez savunmasında jüri "hipotezini doğrulayamadın" diyebiliyor; güç analizinin yapılmış olması, etki büyüklüğünün raporlanması ve metodolojinin sağlamlığı böyle bir durumda en güçlü savunma oluyor.
İpucu
Makalede "gruplar arasında fark yoktur" yerine "istatistiksel olarak anlamlı fark saptanmamıştır" demek ve farkı güven aralığıyla birlikte vermek daha doğru. İlki farkın olmadığını ileri sürüyor, ikincisi kanıt yetersizliğine işaret ediyor. Küçük bir nüans, ama deneyimimizde hakemler bu ayrımı dikkatle takip ediyor.
Negatif sonuçla ne yapılacağı konusunda tereddüt yaşarsanız ya da raporlama sürecinde desteğe ihtiyaç duyarsanız, Model İstatistik CRO ekibi olarak araştırmacıya rehberlik ediyoruz. p > 0,05 çalışmayı değersiz kılmaz; doğru yorum, sonraki araştırmanın tasarımına zemin hazırlayabilir.
Not: Buradaki güç, etki büyüklüğü ve güven aralığı değerleri kavramı göstermek için seçilmiş örneklerdir; gerçek değerler çalışmanın verisine göre değişir.
Kullanılan kaynaklar
- Altman DG, Bland JM. Absence of evidence is not evidence of absence. BMJ. 1995;311(7003):485. · DOI
- Sullivan GM, Feinn R. Using effect size—or why the P value is not enough. Journal of Graduate Medical Education. 2012;4(3):279-282. · DOI
- Wasserstein RL, Lazar NA. The ASA statement on p-values: context, process, and purpose. Am Stat. 2016;70(2):129-133.
- Hoenig JM, Heisey DM. The abuse of power: the pervasive fallacy of power calculations for data analysis. Am Stat. 2001;55(1):19-24.
- Lakens D. Calculating and reporting effect sizes to facilitate cumulative science: a practical primer for t-tests and ANOVAs. Front Psychol. 2013;4:863. PMC3840331
- Wood J, Freemantle N, King M, Nazareth I. Trap of trends to statistical significance: likelihood of near significant P value becoming more significant with extra data. BMJ. 2014;348:g2215. PMID 24687314
- ICMJE. Recommendations for the Conduct, Reporting, Editing, and Publication of Scholarly Work in Medical Journals (Statistics).