
Bir kutu grafiğinde (box plot) birkaç nokta diğerlerinden belirgin biçimde uzakta durabilir; histogramda iki değer çok sağda kalır. Bu üç noktayı silince sonuç anlamlı (p=0,03), bırakınca anlamsız (p=0,12) çıkabiliyor. Böyle bir durumda uç değeri (outlier) silmek cazip gelir; bir tıkla üç satır gider, p-değeri düşer. Ama hakem "bu üç hastayı neden çıkardınız?" diye sorduğunda "uç değerdi" demek bir gerekçe değil. Klinik gerekçe olmadan silmek, veri manipülasyonuna kapı aralar.
Uç değer nedir — gerçekten?
Uç değer, veri setinin geri kalanından istatistiksel olarak uzak olan gözlem demek. Ama "ne kadar uzak?" sorusunun iki farklı cevabı var.
İstatistiksel uç değer: |Z| ≥ 3 olan değerler ya da IQR yöntemiyle Q1 − 1,5×IQR'den küçük veya Q3 + 1,5×IQR'den büyük olanlar. Bu tanım sayılara bakıyor, bağlamdan habersiz.
Klinik/biyolojik uç değer: 80 yaşında kalp hızı 180/dk olan hasta ya da 50 kg ağırlığında hemoglobin 25 g/dL olan kişi. Bu tanım gerçeği arıyor; önemli olan sayılar değil, anlam.
Sık karşılaştığımız sorun, istatistiksel uç değerin silinip klinik uç değerin görmezden gelinmesi. Oysa uç değerler ortalama ve standart sapma tahminlerini önemli ölçüde etkilediğinden, nasıl ele alındıkları sonucu doğrudan değiştiriyor (Kwak ve Kim 2017).
Tespit yöntemleri
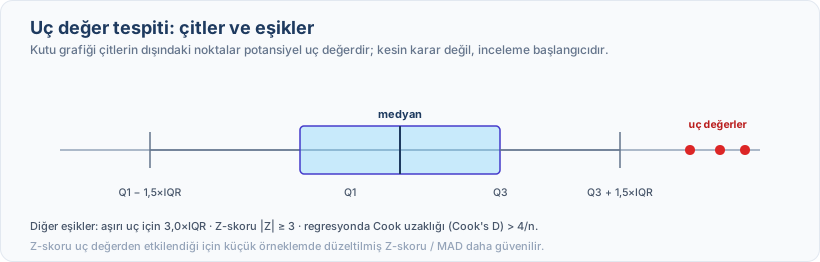
Yöntemlerin hepsinin artı ve eksileri var; birden fazlasını birlikte kullanmak işe yarıyor, ama hangi kuralın uygulanacağını analizden önce belirlemek ve sonuca bakarak değiştirmemek gerekiyor.
Kutu grafiği (box plot): IQR kuralını görselleştirir; bıyıkların dışında ayrı çizilen noktalar 1,5×IQR çitinin dışındadır. Bu noktalar "kesin uç değer" değil, incelenecek aday değerlerdir; her birine tek tek bakmak gerekiyor.
IQR yöntemi (Tukey): Alt sınır Q1 − 1,5×IQR, üst sınır Q3 + 1,5×IQR. Çeyrekler uç değerlerden ortalama ve standart sapma kadar etkilenmediği için bu yöntem Z-skoruna göre daha dayanıklıdır; ancak belirgin çarpık bir dağılımda kuyruktaki gerçek değerleri de işaretleyebilir, bu yüzden önce dağılımın şekline bakmak gerekiyor. 1,5 katsayısı bir uzlaşımdır; aşırı uç değerler için 3,0×IQR çiti kullanılıyor. Eşiğin gerekçelendirilmesi önemli.
Z-skoru: Z = (X − Ortalama) / Standart Sapma. |Z| ≥ 3 eşiği yaygın. Dağılım normale yakınsa ve büyük örneklemlerde uygun. Tuzak: uç değerin kendisi ortalamayı ve standart sapmayı etkiliyor. Medyan mutlak sapmaya (MAD) dayanan düzeltilmiş Z-skoru (modified Z-score, M) gibi dayanıklı (robust) sürümler bu sorunu aşıyor; bu ölçüt için önerilen eşik |M| > 3,5 (NIST/SEMATECH). Ayrıca örneklem standart sapmasıyla hesaplanan klasik Z-skoru, 10 ve daha az gözlemli bir örneklemde 3 eşiğine hiç ulaşamıyor.
Cook uzaklığı (Cook's Distance, regresyon modelleri için): Bir gözlem çıkarıldığında model katsayılarının ne kadar değiştiğini ölçüyor. Sık kullanılan kaba eşik Cook's D > 4/n; farklı yazılımlar farklı ölçütler kullanıyor (örneğin R'nin influence.measures işlevi F dağılımının medyanını). Cook uzaklığı ANOVA dâhil doğrusal modellerde hesaplanabiliyor ve tek başına silme gerekçesi sayılmıyor.
Uç değer bulundu — ne yapmalı?
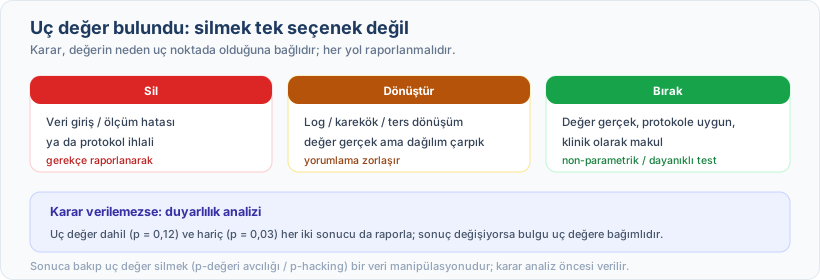
Silmek: Düzeltilemeyen veri giriş hatasında ve ölçüm hatasında değeri silip eksik veri olarak işaretlemek, protokol ihlalinde ise hastanın hangi analizde yer alacağını önceden tanımlanan kurala göre belirlemek mantıklı. Randomize çalışmada hasta tedavi niyetine göre (ITT) analizde kalır, protokole uygun analizden ise çıkarılabilir. Ama silme kararının raporlanması şart. "3 hasta aykırı değer nedeniyle çıkarıldı" değil, "3 hastada düzeltilemeyen veri giriş hatası tespit edildi ve bu değerler eksik veri olarak işaretlendi" yazmak doğru.
Dönüştürmek: Log, karekök veya ters dönüşüm; dağılımı normale yaklaştırıyor, uç değerlerin etkisini azaltıyor. Değer gerçekse ama dağılım çarpıksa uygun. Dönüşüm sonrası yorumlama zorlaşıyor; "log(CRP) ortalaması 1,2 birim düştü" demek, ham CRP'ye çevrilmeden anlam ifade etmiyor.
Bırakmak: Değer gerçekse, protokole uygunsa, klinik olarak makul ise bırakmak en doğru yaklaşım. Non-parametrik testler (Mann-Whitney, Kruskal-Wallis) uç değere daha az duyarlı (Mishra ve ark. 2019); dayanıklı istatistikler (medyan, budanmış ortalama / trimmed mean) de işe yarıyor.
Duyarlılık analizi: en güvenilir yol
Karar verilemediğinde her iki senaryoyu da test etmek en güvenilir yaklaşım:
- Uç değer dâhil → p = 0,12
- Uç değer hariç → p = 0,03
Sonuç değişiyorsa bulgular uç değere bağımlı demek. Bu durumda makalede her iki sonucu da raporlamak, "duyarlılık analizinde 3 uç değer çıkarıldığında sonuç anlamlı hâle geldi (p=0,03)" yazmak ve tartışmada nedenlerini açıklamak en doğru yaklaşım. Bu şeffaflık sayesinde hakem de okur da bulgunun ne kadar sağlam olduğunu kendi başına değerlendirebiliyor.
Sık yapılan hatalar
"p<0,05 için silmek." Bu bir veri manipülasyonu. Uç değer silme kararı analiz öncesi verilmeli; sonuca bakıp karar değiştirmek etik ihlaldir.
"Kutu grafiğinde uçuyor, çıkardım." Kutu grafiği karar verme aracı değil, tespit aracı. Tespit ettikten sonra neden uçtuğunu araştırmak gerekiyor.
"Normallik testi başarısız, uç değerleri çıkarıyorum." Normallik testi başarısız oluyorsa sorun uç değer değil, dağılımın kendisi olabilir. Non-parametrik teste geçmek veya dönüşüm yapmak daha doğru.
Uyarı
Hakemden şöyle bir yorum gelebilir: "Authors removed 3 outliers without justification. This appears to be p-hacking." Yani gerekçesiz uç değer silme, p-değeri avcılığı (p-hacking) olarak okunuyor. Bu yorumu almamak için uç değer yönetimini protokolde tanımlayıp raporlamak önemli.
Raporlama
Yöntem bölümünde uç değer tespit yönteminin belirtilmesi, tespit edilen değerlerin kaynak verilerle kontrol edilmesi ve klinik değerlendirme sürecinin açıklanması gerekiyor. Sonuçlar bölümünde kaç uç değer tespit edildiği, bu hastaların klinik durumu ve duyarlılık analizi sonuçları raporlanmalı.
Uç değer tespiti, veri temizleme sürecinin kritik bir parçası. Tespit sonrası karar aşamasında veri giriş hatalarını önleme stratejileri de dikkate alınmalı. Uç değerler normallik varsayımını etkilediği için, onları normallik testi yöntemleri ile birlikte değerlendirmek daha sağlıklı sonuç veriyor.
Uç değer yönetimini protokolde tanımlayıp önceden belirlendiği gibi uygulamak, hakemin sorularına baştan yanıt veriyor. Model İstatistik CRO ekibi olarak hem veri analizi hem de raporlama süreçlerinde araştırmacının yanında duruyoruz.
Kullanılan kaynaklar
- Kwak SK, Kim JH. Statistical data preparation: management of missing values and outliers. Korean Journal of Anesthesiology. 2017;70(4):407-411. · DOI
- Mishra P, Pandey CM, Singh U, Keshri A, Sabaretnam M. Selection of appropriate statistical methods for data analysis. Annals of Cardiac Anaesthesia. 2019;22(3):297-301. · DOI
- NIST/SEMATECH. e-Handbook of Statistical Methods: 1.3.3.7 Box Plot; 1.3.5.17 Detection of Outliers.