
Beş yüz hastalık, 12 aylık takipli retrospektif bir çalışmada HbA1c değerlerinin %15'i eksik olabilir. SPSS'te regresyon çalıştırıldığında eksik değerli 75 hasta varsayılan olarak analiz dışında kalır ve çıktıdaki N 425'e iner. Asıl soru burada başlıyor: kaybedilen 75 kişi daha genç miydi, glisemik kontrolleri daha mı kötüydü, yoksa yalnızca o dönem laboratuvar mı arızalıydı? Eksik veri probleminde tek bir doğru cevap yoktur; yalnızca "daha az yanlış" seçenekler vardır ve doğru seçim, eksikliğin mekanizmasına bağlıdır.
Eksik veri neden oluşur?
Klinik araştırmalarda eksik veri çoğu zaman hastanın takipten çıkmasından (ölüm, taşınma, ilacı bırakma), testin yapılamamasından (laboratuvar arızası, kitin bitmesi), formun eksik doldurulmasından (hassas sorularda yanıt vermeme, anketör hatası) ve veri kaybından (dosyanın kaybolması, sistemin çökmesi) doğar.
Ama hangi yöntemin uygun olduğunu nedenin türü tek başına belirlemiyor. Belirleyici olan, eksik verinin "mekanizması", yani eksikliğin gözlenen ya da eksik kalan değerlerle ilişkisi. Takipten çıkma, çıkan hastaların özelliklerine göre farklı mekanizmalara uyabilir; veri kaybı da ancak değerlerle ilişkisi yoksa tamamen rastlantısal sayılır.
Üç mekanizma: MCAR, MAR, MNAR
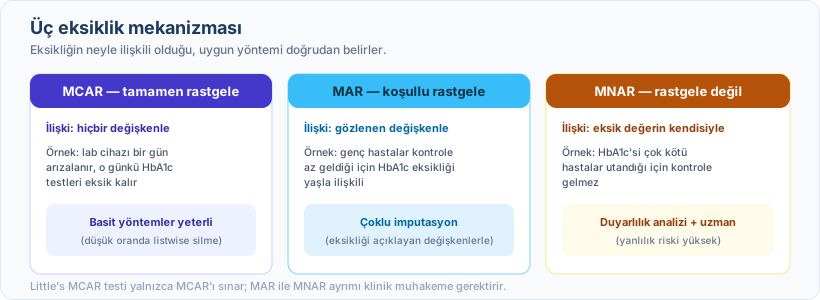
MCAR (Missing Completely at Random, tamamen rastgele): Eksiklik tamamen rastlantısal. HbA1c değeri eksik olanlarla olmayanlar arasında sistematik bir fark yok. Hastanenin laboratuvar cihazı belli bir tarihte arızalandı ve o gün gelen herkesin testi eksik kaldı; bunun hastanın yaşıyla ya da hastalığının şiddetiyle ilgisi yok.
MAR (Missing at Random, koşullu rastgele): Eksiklik gözlenen başka bir değişkene bağlı; o değişken hesaba katıldığında eksik değerin kendisiyle ilişkisi kalmıyor. Genç hastalarda HbA1c testi daha sık eksik, çünkü gençler kontrole daha az geliyor. Eksik değerler ortalamada gözlenenlerden farklı olabilir, ama bu fark yaşla açıklanıyor; aynı yaştaki hastalar arasında eksiklik HbA1c değerine bağlı değil.
MNAR (Missing Not at Random, rastgele değil): Eksiklik, eksik olan değerin kendisiyle ilişkili. HbA1c değeri çok kötü olan hastalar utandıkları için kontrole gelmiyor. Eksik veri görmezden gelinirse ortalama HbA1c olduğundan daha iyi görünüyor.
Mekanizmaları kesin olarak ayırt eden bir test yok. SPSS'teki Little's MCAR testi, MCAR varsayımını sıfır hipotezi olarak sınıyor. p < 0,05 çıkarsa MCAR varsayımı reddediliyor, ama test MAR ile MNAR arasında ayrım yapmıyor; p > 0,05 ise MCAR'ı kanıtlamıyor, yalnız reddedemiyor. Eksik ve tam gözlemli hastaları demografik ve klinik özellikler bakımından karşılaştırmak da raporlanması önerilen bir adım (Sterne ve ark. 2009); fark bulunması MCAR'ı zayıflatır, fark bulunmaması ise MCAR'ı kanıtlamaz. MAR ile MNAR arasındaki ayrım veriden sınanamıyor, klinik bilgiyle tartışmak gerekiyor. Bu testin ne söyleyip ne söylemediğine ve ileri yöntemlere eksik veri analizi yöntemleri yazımızda ayrıntılı değiniyoruz.
Yöntem 1: Silme
Liste bazlı silme (listwise deletion / tam gözlem analizi): Eksik veri içeren satır analizden tümüyle çıkarılıyor. SPSS regresyonda varsayılan olarak bunu yapıyor (korelasyonda varsayılan ikili silme). Basit, anlaşılır ve MCAR varsayımı geçerliyse yanlılık oluşturmuyor. Ama örneklem küçülüyor, istatistiksel güç düşüyor; kaybın ne kadar ciddi olduğunu bir yüzde eşiği değil, kalan hasta sayısının analize yetip yetmediği belirliyor. MAR ya da MNAR durumunda yanlılık oluşabilir; eksiklik sonuç değişkenine bağlı değilse regresyon katsayıları yansız kalabiliyor.
Eksiklik %5'in altındaysa ve belirli hasta gruplarının (örneğin en ağır hastaların) seçici olarak kaybolması akla yatkın değilse, liste bazlı silme kaba bir kural olarak ana analizde kullanılabilir (Jakobsen ve ark. 2017).
İkili silme (pairwise deletion): Her analiz, yalnız kendi değişkenlerinde eksiği olan hastaları dışarıda bırakıyor. Bu yüzden korelasyon matrisinin her hücresi farklı bir alt örneklemden gelebiliyor ve matris "pozitif tanımlı" olmayabiliyor; çoğu çok değişkenli yöntem bu koşulu arıyor. Keşifsel analizlerde kullanılabilir, ama son analiz için önerilmiyor.
Yöntem 2: Basit doldurma (tekli imputasyon)
Ortalama/medyan ile doldurma: Eksik değerler değişkenin ortalaması veya medyanı ile dolduruluyor. Örneklem sayısı aynı kalıyor, ama varyans azalıyor, korelasyonlar zayıflıyor ve standart hatalar olduğundan küçük çıkıyor; bu sorunlar MCAR'da bile geçerli. Ortalama ile doldurma MCAR'da bile yalnız ortalamayı yansız bırakıyor; standart sapma ve yüzdelikler bozulduğu için yöntem betimleyici tablolarda da, çıkarımsal analizde (t-testi, regresyon) de önerilmiyor.
LOCF (Last Observation Carried Forward, son gözlemi taşıma): Uzunlamasına çalışmalarda eksik değer, son bilinen değerle dolduruluyor. Yöntem, hastanın ayrıldığı andan sonra hiçbir değişim olmadığını varsayıyor; iyileşmenin sürdüğü bir durumda iyileşmeyi, kötüleşmenin sürdüğü bir durumda kötüleşmeyi olduğundan küçük gösteriyor. Belirsizliği yok saydığı için varyansı da düşük tahmin ediyor; bu yüzden ana analiz yöntemi olarak önerilmiyor (Lachin 2016).
Yöntem 3: Çoklu imputasyon (multiple imputation)
Çoklu imputasyon, güncel yöntem literatürünün önerdiği iki ana yaklaşımdan biri (öteki, en çok olabilirlik yöntemleri; Schafer ve Graham 2002); ancak sonucun geçerliliği imputasyon modelinin nasıl kurulduğuna bağlı. Üç aşamada çalışıyor:
- İmputasyon: Eksik değerler tahmin edilerek (regresyon veya öngörücü ortalama eşleme, PMM) birden fazla tamamlanmış veri seti oluşturuluyor.
- Analiz: Her veri setinde ayrı ayrı analiz yapılıyor.
- Havuzlama: Sonuçlar Rubin kurallarıyla birleştiriliyor, ortalama ve varyans hesaplanıyor.
Yöntem, imputasyon belirsizliğini hesaba kattığı için standart hataları gerçekçi veriyor ve model doğru kurulduysa MAR varsayımı altında yanlılık oluşturmuyor. Teknik olarak karmaşık ama SPSS'te "Analyze → Multiple Imputation" menüsünden yapılabiliyor. Kaç veri seti üretileceği (m) sabit bir sayı değil; White ve arkadaşlarının (2011) yaygınlaşan kuralına göre m, eksik verisi olan hastaların yüzdesinden az olmamalı (hastaların %15'inde en az bir değişken eksikse m ≥ 15). Bunun gerekçesini ve MICE/FIML gibi ileri yöntemleri eksik veri analizi yazımızda derinlemesine ele alıyoruz.
Akademik Not
Standart çoklu imputasyon MAR varsayımına dayanıyor. MNAR şüphesi varsa duyarlılık analizi önemli; eksik değerlerin gözlenenlerden belirli bir miktar daha kötü ya da daha iyi olduğu varsayılan senaryolarla imputasyon yapılıp sonuçların nasıl değiştiğine bakılıyor. İkili bir sonuçta ve az sayıda eksikte en iyi ve en kötü senaryo da kullanılabilir. Sonuçlar tutarlıysa bulgular dayanıklı, tutarsızsa dikkatli yorumlamak gerekiyor.
Hangi yöntem?
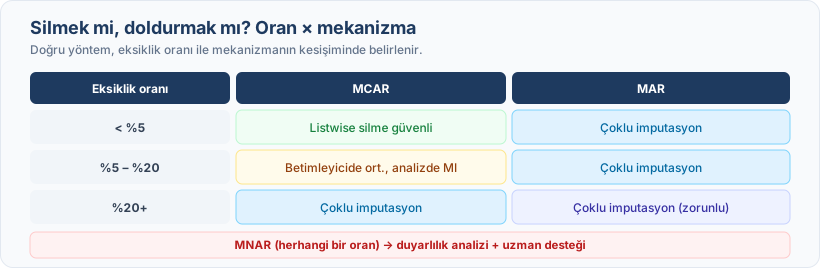
| Eksiklik Oranı | Mekanizma | Önerilen Yöntem |
|---|---|---|
| < %5 | MCAR | Liste bazlı silme |
| %5-20 | MCAR | Çoklu imputasyon (liste bazlı silme yansız ama güç kaybı artar) |
| %5-20 | MAR | Çoklu imputasyon |
| %20+ | MAR | Çoklu imputasyon + duyarlılık analizi |
| Herhangi | MNAR | Duyarlılık analizi + uzman desteği |
Raporlama
CONSORT ve STROBE kılavuzları eksik veri yönetiminin raporlanmasını gerektiriyor. Yöntem bölümünde eksik veri mekanizmasının nasıl değerlendirildiği, hangi yöntemin kullanıldığı, imputasyon modeline hangi değişkenlerin dâhil edildiği ve kaç veri seti üretildiği belirtilmeli. Sonuçlar bölümünde kaç hastada eksiklik olduğu ve eksik veri olanlarla olmayanlar arasında fark olup olmadığı raporlanmalı (Sterne ve ark. 2009).
Emin olunmadığında hem liste bazlı silmeyle hem çoklu imputasyonla analiz yapmak işe yarıyor (Sterne ve ark. 2009). Sonuçlar benzer çıkarsa bulgulara güven artar; farklı çıkarsa bunun olası nedenlerini Tartışma bölümünde ele almak gerekiyor.
Eksik veriyi baştan önlemek
Eksik veriyi veri toplama sırasında en aza indirmek, analiz aşamasında çözmekten çok daha verimli. Prospektif çalışmalarda takip hatırlatmaları, esnek randevu saatleri ve alternatif iletişim kanalları yardımcı oluyor. Retrospektif çalışmalarda çoklu kaynak kullanımı (hastane kayıtları + e-Nabız + laboratuvar sistemi) eksikliği azaltıyor. Anket çalışmalarında soru sayısını gerekenle sınırlamak boş bırakılan alanları azaltabiliyor; hassas sorulara eklenen "Cevaplamak istemiyorum" seçeneği ise yanıt vermemenin nedenini kayda geçiriyor.
Eksik veri problemi her çalışmada farklı bir yaklaşım gerektiriyor. Model İstatistik CRO ekibi olarak hem istatistik analiz hem de veri kalitesi süreçlerinde araştırmacının yanında duruyoruz.
Kullanılan kaynaklar
- Rubin DB. Inference and missing data. Biometrika. 1976;63(3):581-592. · DOI
- Schafer JL, Graham JW. Missing data: our view of the state of the art. Psychological Methods. 2002;7(2):147-177. · PMID: 12090408
- Sterne JAC, White IR, Carlin JB, Spratt M, Royston P, Kenward MG, Wood AM, Carpenter JR. Multiple imputation for missing data in epidemiological and clinical research: potential and pitfalls. BMJ. 2009;338:b2393. · DOI
- White IR, Royston P, Wood AM. Multiple imputation using chained equations: issues and guidance for practice. Statistics in Medicine. 2011;30(4):377-399. · DOI
- Jakobsen JC, Gluud C, Wetterslev J, Winkel P. When and how should multiple imputation be used for handling missing data in randomised clinical trials: a practical guide with flowcharts. BMC Medical Research Methodology. 2017;17(1):162. · PMID: 29207961
- Madley-Dowd P, Hughes R, Tilling K, Heron J. The proportion of missing data should not be used to guide decisions on multiple imputation. Journal of Clinical Epidemiology. 2019;110:63-73. · PMID: 30878639
- Lachin JM. Fallacies of last observation carried forward analyses. Clinical Trials. 2016;13(2):161-168. · PMID: 26400875