
Bir lojistik regresyon modeline yaş, BMI, trigliserid, total kolesterol, LDL, HDL, glukoz ve insülini birlikte koyduğunuzda çıktıda tuhaf işaretler görebilirsiniz. Bazı katsayılar mantıksız görünür, kimi p değerleri 0,90'a yaklaşır, kimi standart hatalar aşırı büyür. Bu tablonun sık görülen nedeni çoklu bağlantıdır (multicollinearity), yani bağımsız değişkenlerin birbiriyle yüksek korelasyonlu olması. Vatcheva ve arkadaşlarının (2016) gösterdiği gibi, çoklu bağlantı göz ardı edildiğinde sonuçların yorumu yanıltıcı olabilir.
Çoklu bağlantı ne demek?
Çoklu bağlantı, bağımsız değişkenlerin birbiriyle yüksek korelasyonlu olmasıdır. Modele "her biri bağımsız bir etkiye sahip" varsayımıyla eklenen değişkenler aslında birbiriyle iç içeyse, model, katsayıları kararlı biçimde hesaplayamıyor.
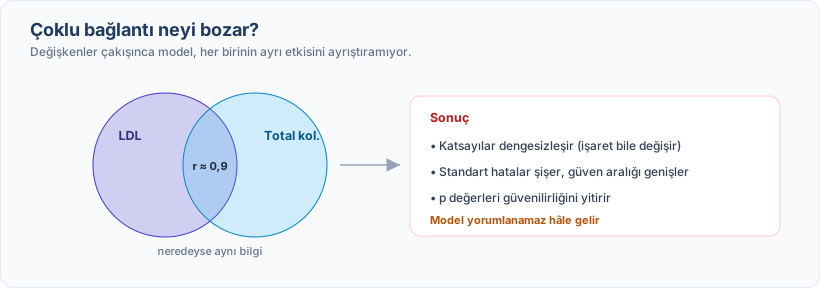
LDL ile total kolesterol arasında r = 0,90 dolayında bir korelasyon varsa, ikisi aynı modele konulduğunda model zorlanıyor. Bu iki değişken büyük ölçüde aynı bilgiyi taşıdığı için etkilerini birbirinden güvenilir biçimde ayırmak zorlaşıyor; katsayılar büyüyüp küçülüyor, standart hatalar şişiyor ve p değerleri güvenilirliğini yitiriyor. Değişkenlerden biri ötekilerin doğrusal bir birleşimiyse (örneğin non-HDL kolesterol = total kolesterol − HDL) bağlantı tamdır; bu durumda katsayıları ayırmak hiç mümkün olmaz ve yazılım değişkenlerden birini modelden çıkarır. Danışmanlık sürecimizde 12 bağımsız değişkenli bir modelle karşılaştık; değişkenlerin 7'si kan lipid paneli parametresiydi ve VIF değerleri 30-40 bandındaydı. Hakem ilk yorumunda modelin yorumlanamadığını belirterek değişken sayısının azaltılmasını istedi.
Nasıl tespit edilir?
İki yöntem öne çıkıyor: korelasyon matrisi ve VIF (varyans şişirme faktörü, Variance Inflation Factor). Korelasyon matrisi basit ama yüzeyseldir. İki değişken arasındaki ikili korelasyona bakar; r > 0,80 olası bir soruna işaret eder. Ancak çoklu bağlantı üç veya daha fazla değişken arasında da oluşabildiğinden, ikili korelasyonlar düşük görünse bile model kararsızlaşabilir. VIF daha güvenilirdir, çünkü her değişkenin diğer bağımsız değişkenlerce ne kadar açıklandığını ölçer.
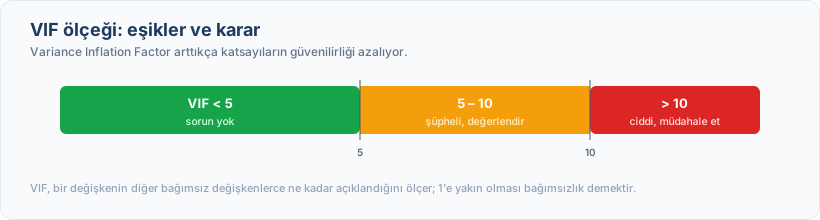
Kim'in (2019) belirttiği gibi katsayıların varyansı VIF ile orantılı olarak arttığından, yüksek VIF doğrudan güvenilmez p değerleri ve güven aralıkları üretiyor. SPSS'te Linear Regression > Statistics > Collinearity diagnostics yolu, R'da car::vif() fonksiyonu, Stata'da regress komutundan sonra estat vif komutu VIF verir.
VIF'e göre karar
Çoklu bağlantı ne yapıyor?
Çoklu bağlantı modeli görünürde bozmaz; R² yüksek çıkabilirken katsayılar güvenilir olmaz. Katsayılar dengesizleşiyor: LDL için β = 2,3 (p = 0,02), total kolesterol için β = −4,1 (p = 0,87) bulunabiliyor ve total kolesterol hakkında güvenilir bir yorum yapmak imkânsız hâle geliyor, çünkü LDL ile büyük ölçüde aynı bilgiyi taşıyor. Standart hatalar şişiyor: tahmin kararlı olmadığında güven aralığı genişliyor ve gerçekte etkili bir değişken bile anlamsız çıkabiliyor. Model yorumlanamaz hâle geliyor: modelde bel çevresi de varsa "BMI arttıkça risk azalıyor" gibi mantıksız bir bulgu çıkabilir, çünkü iki değişken büyük ölçüde aynı özelliği ölçüyor. Daha kötüsü, model farklı bir örneklemde tekrarlandığında katsayılar tamamen değişebiliyor; bu, tekrarlanabilirlik açısından ciddi bir sorun.
Üç ana çözüm yolu var; hangisinin uygun olduğu değişkenlerin klinik değerine ve çalışmanın amacına bağlı:
| Çözüm | Ne zaman | Avantaj | Dikkat |
|---|---|---|---|
| Değişken eleme | İlişkili çiftten biri feda edilebiliyorsa | Basit, model yorumlanabilir kalır | Seçim klinik gerekçeye dayanmalı; sonuç üzerinde gerçek etkisi olan bir değişkeni çıkarmak yanlılığa yol açabilir |
| Birleşik skor / PCA | Değişkenlerin hepsi klinik anlamlıysa | Bilgi korunur | Bileşenin klinik anlamı açıklanmalı |
| Cezalı regresyon (Ridge/Lasso) | Çok değişkenli, tahmin odaklı model | Ridge, katsayıları kararlı hâle getirir; Lasso değişken seçer | Biyomedikalde henüz standart değil |
Çözüm 1: değişken eleme
En basit çözüm, ilişkili değişkenlerden birini çıkarmak. Total kolesterol ile LDL arasında r = 0,92 korelasyon varsa ikisinden biri seçilebilir; hangisinin kalacağını klinik mantık ve literatür belirliyor (kardiyovasküler risk modelinde LDL daha özgül olduğu için sık tercih ediliyor). Kim'in (2019) uyardığı gibi, sonuç üzerinde gerçek etkisi olan bir değişkeni modelden çıkarmak katsayıları yanlı kılar ve bu, çoklu bağlantıdan daha ciddi bir sorun doğurabilir. Danışmanlıklarımızda en sık uyguladığımız yol yinelemelidir. Korelasyon matrisini çizip 0,80 üzeri korelasyonları not ediyoruz, bu çiftlerde hangi değişkenin kalacağına klinik gerekçeyle karar veriyoruz ve VIF'i yeniden hesaplıyoruz; VIF hâlâ 10 üzerindeyse, VIF'i yüksek kalan değişkenler arasından klinik gerekçeyle bir değişken daha çıkarıp VIF'i yeniden hesaplıyoruz. Örneğin 12 değişkenli bir modelde 5 değişken birbiriyle yüksek korelasyonluysa, klinik gerekçeyle 3'ünü çıkarmak modeli yorumlanabilir hâle getirebilir.
Çözüm 2: birleştirme veya PCA
Bazen değişken çıkarmak istenmez, çünkü hepsi klinik olarak anlamlıdır; bu durumda birleştirme düşünülebilir. Birleşik skor (composite score): lipid değişkenlerini tek bir göstergede birleştirmek mümkün. Bunun için klinikte kullanılan bir oran (örneğin total kolesterol/HDL) ya da standartlaştırılmış değerlerden kurulan, yönü ve ağırlığı önceden gerekçelendirilmiş bir skor uygun olur; birimleri ve klinik yönleri farklı değişkenlerin ham ortalaması anlamlı bir skor vermez. Temel bileşen analizi (PCA): yüksek korelasyonlu değişkenleri boyut indirgemeyle birleştirir; ilk 2-3 temel bileşen orijinal değişkenlerin varyansının büyük bölümünü açıklıyorsa bunları modele almak mümkün. Ancak yorumlama zorlaşıyor, çünkü ilk bileşenin klinik olarak ne anlama geldiğini tartışma bölümünde açıklamak gerekiyor.
İpucu
VIF hesaplandıktan sonra değişken çıkarmaya başlamadan önce korelasyon matrisini çizip değişkenleri klinik gruplara ayırmak işe yarar; lipid değişkenleri bir grup, inflamasyon belirteçleri başka bir grup olur. Her gruptan klinik açıdan en anlamlı değişken bırakılıp diğerleri çıkarıldığında hem çoklu bağlantı azalıyor hem de model yorumlanabilir kalıyor.
Çözüm 3: Ridge/Lasso regresyon
Klasik regresyon yerine cezalı regresyon (penalized regression) da bir seçenek. Ridge regresyon katsayıları sıfıra doğru büzerek kararlı hâle getiriyor; Lasso regresyon ise bazı katsayıları tam sıfır yaparak otomatik değişken eleme yapıyor. Bu yöntemler makine öğrenmesi tabanlı çalışmalarda yaygın, ama klasik biyomedikal dergilerde henüz standart değil; kullanılacaksa yöntemde açıkça belirtilmesi ve sonuçların klasik regresyonla karşılaştırılması bekleniyor. Lojistik regresyonda OR ve CI raporlama kuralları bu karşılaştırmada referans oluşturuyor.
Raporlama
Regresyon analizinde VIF değerlerinin belirtilmesi bekleniyor: "Çoklu bağlantı değerlendirmesi varyans şişirme faktörü (VIF) ile yapılmış, tüm değişkenler için VIF < 5 bulunmuştur." Yüksek VIF bulunup değişken çıkarıldıysa: "Başlangıçta 10 bağımsız değişken değerlendirilmiş, ancak VIF > 10 nedeniyle total kolesterol ve VLDL modelden çıkarılmıştır." Bu şeffaflık, hakemlerin "neden bu değişken yok?" sorusunu önceden yanıtlıyor. Değişken seçim sürecinin tamamını lojistik regresyon model kurma yazımızda ayrıntılı ele aldık.
VIF düşük ama model hâlâ tutarsız?
VIF < 5 olmasına rağmen model tutarsız sonuç veriyorsa birkaç olasılık var. Gözden kaçan çoklu bağlantı: Vatcheva ve arkadaşları (2016), VIF 5'in altındayken bile sonuçların etkilenebildiğini ve ikili korelasyonları zayıf (r = 0,25) olan ikiden fazla değişkenin belirgin bir çoklu bağlantı etkisi yaratabildiğini bildiriyor. Örneklem yetersizliği: sık kullanılan pratik kural değişken başına en az 10 olaydır (EPV; bazı yazarlar 15 önerir); 8 değişkenli bir modelde olay sayısı 45 ise model aşırı uyum (overfitting) yapıyor olabilir. Doğrusal olmayan ilişki (non-linearity): değişkenler arasında doğrusal olmayan bir ilişki varsa katsayılar yanıltıcı çıkabilir; spline veya kategorik dönüşüm denenebilir. Etkili gözlem (influential case): birkaç uç gözlem tüm modeli bozabilir ve Cook uzaklığıyla kontrol edilmesi önerilir. VIF tek başına yeterli değil, model tanı araçlarının yalnızca bir parçası; p değeri anlamsız çıktığında ne yapılacağını bilmek de bu değerlendirmenin doğal tamamlayıcısı.
Model İstatistik ekibi olarak regresyon modelinin kurulmasından çoklu bağlantı değerlendirmesine, değişken seçiminden raporlamaya kadar araştırmacıya rehberlik ediyoruz.
Not: Buradaki korelasyon, VIF ve katsayı değerleri kavramı göstermek için seçilmiş örneklerdir; eşikler yol gösterici niteliktedir ve kesin karar çalışmanın verisi üzerinden verilir.