
Lojistik regresyon analizini çalıştırmak birkaç tıkla mümkün; ama modelin uyumunu değerlendirmek, değişken seçimini gerekçelendirmek ve sonuçları doğru raporlamak apayrı bir aşama. Deneyimimizde hakem eleştirileri de çoğu zaman burada yoğunlaşıyor: "Hosmer-Lemeshow testi sonucu nedir? Nagelkerke R² kaçtır? AUC değerini neden raporlamadınız?"
Bu yazı, lojistik regresyon modelini kurma ve doğrulama tarafına odaklanıyor; çıktıdaki odds ratio ile güven aralığını okuma tarafını ise lojistik regresyon OR ve CI yorumlama yazımız ele alıyor.
Üç lojistik regresyon türü
Doğru türü seçmek, analizin ilk kritik kararı:
| Tür | Bağımlı değişken | Örnek | Çıktı |
|---|---|---|---|
| Binary | 2 kategori | Hastalık var/yok | Odds ratio |
| Multinomial | 3+ kategori, sırasız | Tanı tipi (A, B, C) | OR (referansa göre) |
| Ordinal | 3+ kategori, sıralı | Evre I/II/III/IV | Kümülatif OR |
Binary lojistik regresyon, sonuç evet/hayır biçiminde ikili olduğunda doğrudan uygulanıyor. Ordinal lojistik regresyonda proportional odds (orantılı odds) varsayımının Brant testiyle kontrol edilmesi gerekiyor; sağlanmadığında ayrı binary modeller ya da multinomial lojistik regresyon düşünülmeli. Türü doğru belirlemek için istatistik testi seçimi yazımız kararı sistematik hâle getiriyor.
Model kurma stratejisi
Rastgele değişken ekleme-çıkarma yaklaşımı overfitting'e ve veri güdümlü hatalara yol açıyor. Sistematik bir model kurma süreci hem bilimsel güvenilirliği hem de hakem değerlendirmesindeki başarıyı artırıyor.
İki aşamalı model kurma
Tek değişkenli ön tarama
Araştırmacı karıştırıcıları önceden konu bilgisiyle belirler; kaynaklar tek değişkenli p eleğini önermiyor (Sun ve ark., 1996; Heinze ve ark., 2018). Eleme kullanılacaksa amaçlı seçimdeki gibi gevşek bir p eşiği (0,20–0,25) katsayı değişimi ölçütüyle birlikte uygulanıyor; yaş ve cinsiyet gibi klinik olarak önemli değişkenler anlamlı çıkmasa da modelde kalıyor.
Çok değişkenli model (Enter yöntemi)
Önceden belirlenen (eleme yapıldıysa ön taramadan geçen) değişkenler birlikte modele alınır; gerekirse backward eleme modeli sadeleştirir. Klinik gerekçe olmadan değişken çıkarmak önerilmiyor.
EPV kontrolü
Olayın az gözlenen kategorisindeki sayı kontrol edilir; pratik kural olarak her kovaryat için en az 10 olay öneriliyor. 40 olay varsa modele en fazla 4 değişken girebilir.
Model uyumu değerlendirmesi
Hosmer-Lemeshow testi, Nagelkerke R², AUC ve sınıflandırma tablosuyla modelin veriye uyumu değerlendirilir.
EPV kuralı neden kritik?
Değişken başına olay sayısı (events per variable, EPV), modele alınabilecek kovaryat sayısı için pratik bir üst sınır veriyor. 200 hastanın 40'ında olay gerçekleştiyse, EPV = 10 kuralına göre modele en fazla 4 kovaryat girer. Peduzzi ve arkadaşlarının (1996) simülasyon çalışması, EPV 10'un altına indiğinde katsayı tahminlerinin yanlılaştığını, güven aralıklarının doğru kapsama vermediğini ve hatta yanlış yönde anlamlı sonuçların arttığını gösteriyor; 10 ve üzerinde ise ciddi sorun ortaya çıkmıyor. Bu yüzden EPV, model karmaşıklığının üst sınırı için ilk kontrol; yine de 10 eşiği kesin bir sınır değil, gevşetilebilen pratik bir kural (Vittinghoff ve McCulloch, 2007).
Değişken seçim yöntemleri
| Yöntem | Ne zaman? | Dikkat |
|---|---|---|
| Enter | Doğrulayıcı çalışmalar (önerilen) | Araştırmacı kontrolü, karıştırıcılar dâhil |
| Backward | Aday değişken listesi uzunsa | Baskılama etkisini yakalıyor |
| Forward | Keşifsel ön tarama | Karıştırıcı atlama riski var |
| Stepwise | Genel olarak önerilmiyor | Overfitting, düşük tekrarlanabilirlik |
İpucu
Tek değişkenli eleme kullanılacaksa p<0,05 yerine gevşek bir eşik (0,20–0,25) daha az karıştırıcı kaçırıyor; katı bir eşik önemli karıştırıcıları dışarıda bırakabiliyor. Yine de en güvenli yol, karıştırıcıları veriye bakmadan konu bilgisiyle belirlemek (Heinze ve ark., 2018).
Model uyumu: dört gösterge
Hosmer-Lemeshow testi
Gözlenen ve beklenen olay sayılarını karşılaştırıyor. p>0,05 belirgin bir uyumsuzluk saptanmadığını gösterir, ama uyumu kanıtlamaz; testin gücü küçük ve orta büyüklükteki örneklemlerde düşük, sonucu da gruplama biçimine (grup sayısı ve kesim noktaları) duyarlı. p<0,05 çıktığında modelin gözden geçirilmesi gerekiyor: eksik değişken mi var, etkileşim terimi mi gerekiyor? Öte yandan çok büyük örneklemlerde test aşırı hassaslaşıp önemsiz sapmaları bile "kötü uyum" olarak işaretleyebiliyor; bu yüzden tek başına yeterli değil, kalibrasyon eğrisiyle birlikte yorumlanmalı.
Nagelkerke R²
Nagelkerke R² bir sözde R²; doğrusal regresyondaki gibi açıklanan varyans oranı olarak yorumlanmaz ve en çok aynı veride modelleri karşılaştırmak için işe yarar. Bu yüzden genel bir kabul eşiği yok; 0,15 gibi düşük bir değer tek başına modeli geçersiz kılmaz, model performansı ayırt edicilik ve kalibrasyonla değerlendirilir.
ROC eğrisi ve AUC
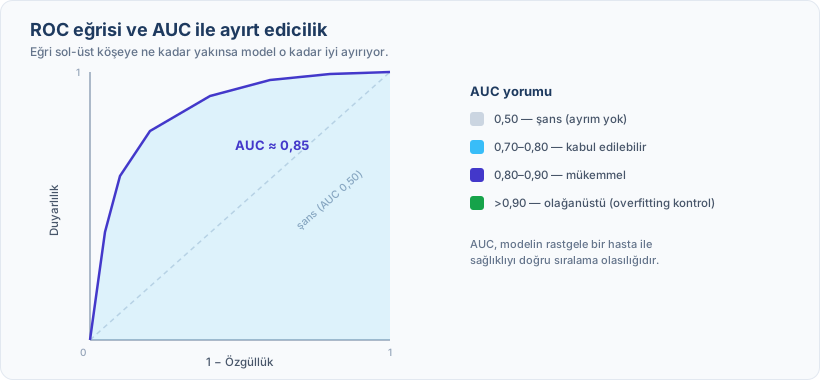
Modelin ayırt edicilik gücü için yaygın kullanılan ölçü. AUC (eğri altındaki alan), modelin rastgele bir hastayı sağlıklı bir bireyden doğru sıralama olasılığını tek bir sayıyla özetliyor:
| AUC | Yorum |
|---|---|
| 0,50 | Şans düzeyi (ayrım yok) |
| 0,50-0,70 | Zayıf–sınırda |
| 0,70-0,80 | Kabul edilebilir |
| 0,80-0,90 | Mükemmel |
| >0,90 | Olağanüstü (overfitting kontrol edilmeli) |
Sınıflandırma tablosu
Doğru sınıflandırma oranını gösteriyor ama dengesiz veri setlerinde yanıltıcı olabiliyor; bir kategoride hastaların %90'ı varsa, herkesi o kategoriye atan bir strateji bile %90 doğruluk verir. ROC eğrisi bu tuzağı aşıyor.
Çoklu doğrusallık kontrolü
Bağımsız değişkenler arasında yüksek korelasyon, OR tahminlerini dengesizleştirip standart hataları şişiriyor. Korelasyon matrisinde r>0,80 olan değişken çiftleri ve VIF>10 olan değişkenler sorunlu kabul ediliyor (kimi kaynaklar VIF>5'i uyarı eşiği alıyor). Eşikler üzerinde uzlaşı yok (Vatcheva ve ark., 2016). Çözüm olarak ilişkili değişkenlerden birini çıkarmak, birleşik bir değişken (indeks, toplam skor) oluşturmak ya da boyut indirgemeye başvurmak mümkün. Ayrıntıyı multicollinearity sorunu yazımızda ele aldık.
Raporlama standardı
Yöntem bölümünde belirtilmesi gerekenler: lojistik regresyon türü, model kurma stratejisi ve gerekçesi, tek değişkenli ön tarama eşiği, modele alınan kovaryat listesi, çoklu doğrusallık kontrolü, model uyumu yöntemleri ve kullanılan yazılım. Sonuçlar bölümünde ise crude ve adjusted OR tabloları, %95 güven aralıkları, p değerleri, Hosmer-Lemeshow, Nagelkerke R² ve AUC yer almalı.
Örnek raporlama: "Çok değişkenli lojistik regresyon analizinde sigara kullanımı (adjusted OR = 3,12; %95 GA 1,85-5,26; p<0,001), diyabet varlığı (adjusted OR = 2,41; %95 GA 1,42-4,09; p=0,001) ve her 10 yıllık yaş artışı (adjusted OR = 1,68; %95 GA 1,22-2,31; p=0,001) bağımsız risk faktörleri olarak belirlendi. Hosmer-Lemeshow testi belirgin bir uyumsuzluk göstermedi (p=0,556); Nagelkerke R² = 0,24, AUC = 0,78."
OR'un ne anlama geldiği ve güven aralığının nasıl okunacağı için lojistik regresyon OR ve CI yorumlama yazımız tamamlayıcı bir kaynak; p değeri anlamsız çıktığında ne yapılacağı da bu sürecin doğal bir parçası. Model İstatistik ekibi olarak lojistik regresyon modelinizin kurulmasından uyum değerlendirmesine ve raporlamaya kadar her aşamada rehberlik ediyoruz.
Not: Buradaki eşikler (EPV, AUC bantları) yaygın kabul gören yol gösterici değerlerdir; kesin karar çalışmanın verisi, sonuç sıklığı ve tasarımı üzerinden verilir.
Kullanılan kaynaklar
- Peduzzi P, Concato J, Kemper E, Holford TR, Feinstein AR. A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology. 1996;49(12):1373-1379. · DOI
- Hosmer DW, Lemeshow S, Sturdivant RX. Applied Logistic Regression. 3. baskı. Hoboken, NJ: Wiley; 2013.
- Sun GW, Shook TL, Kay GL. Inappropriate use of bivariable analysis to screen risk factors for use in multivariable analysis. J Clin Epidemiol. 1996;49(8):907-916. PMID 8699212
- Heinze G, Wallisch C, Dunkler D. Variable selection – A review and recommendations for the practicing statistician. Biom J. 2018;60(3):431-449.
- Vittinghoff E, McCulloch CE. Relaxing the rule of ten events per variable in logistic and Cox regression. Am J Epidemiol. 2007;165(6):710-718.
- Vatcheva KP, Lee M, McCormick JB, Rahbar MH. Multicollinearity in regression analyses conducted in epidemiologic studies. Epidemiology (Sunnyvale). 2016;6(2):227.