
Güç analizinin üç girdisi var: alfa, güç ve etki büyüklüğü. İlk ikisinin olağan değerleri tanıdık (alfa 0,05, güç 0,80). Ama sıra etki büyüklüğüne (effect size) geldiğinde duraksamak kolay: G*Power'daki o kutuya ne yazılacak? 0,5 mi, 0,8 mi? Önceki bir çalışmadan mı alınacak, yoksa "küçük etki" deyip 0,2 mi girilecek?
Bu adımın kafa karıştırması boşuna değil; yanlış belirlenen bir etki büyüklüğü ya gereğinden büyük bir örnekleme ya da yetersiz güce yol açıyor. Neyse ki değeri belirlemenin dört farklı yolu var ve her birinin güçlü ve zayıf yanları belli.
Belirlediğiniz etki büyüklüğünü girip gerekli örneklemi anında görmek için web sitemizdeki örneklem hesaplama aracını kullanabilirsiniz; Cohen's d, oran farkı ve korelasyon için ortalama ve standart sapmadan da etki büyüklüğü türetebiliyor.
Etki büyüklüğü nedir ve neden bu kadar belirleyici?
Etki büyüklüğü, gruplar arasındaki farkın ya da bir ilişkinin büyüklüğünü ifade ediyor. p değerinden farklı olarak örneklem büyüklüğünden etkilenmiyor; küçük örneklemde bile büyük bir etki saptanabilirken, çok büyük örneklemde önemsiz bir etki "anlamlı" çıkabiliyor. Güç analizi tam da bu yüzden etki büyüklüğüne dayanıyor; size "bu büyüklükte bir farkı yakalamak için kaç kişi gerekir?" sorusunun yanıtını veriyor. Sullivan ve Feinn'in (2012) vurguladığı gibi, etki büyüklüğü sonucun pratik önemini p değerinin tek başına söyleyemediği biçimde ortaya koyuyor.
Peki bu büyüklük nereden bilinecek? Dört strateji üzerinden gidelim.
Strateji 1: literatürden almak
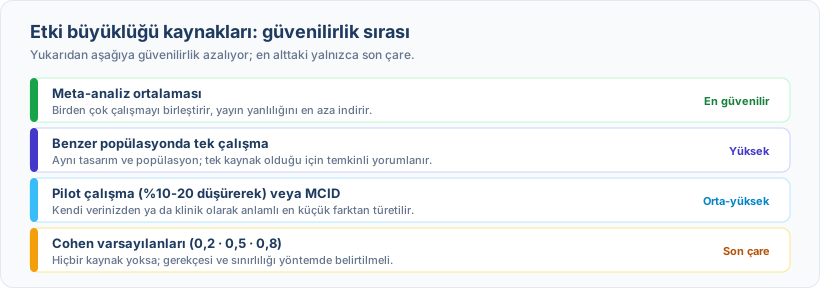
En güvenilir yol. Benzer popülasyonda, benzer tasarımla yapılmış bir çalışma varsa etki büyüklüğü onun sonuçlarından hesaplanabiliyor. Örneğin retrospektif bir çalışmada iki grup karşılaştırılmış, ortalama HbA1c farkı 1,2 ve standart sapma 2,0 civarıysa Cohen's d = 1,2 / 2,0 = 0,6 olur ve G*Power'a 0,6 girilebilir. Literatürde p değeri ile örneklem verilmiş ama etki büyüklüğü raporlanmamışsa, bu değerlerden etki büyüklüğüne geçiş yapan hesaplama yöntemleri de mevcut (Lakens, 2013 bu dönüşümleri ayrıntılı ele alıyor).
Tek uyarı: yayımlanmış çalışmalardaki etki büyüklükleri, yayın yanlılığı (publication bias) nedeniyle abartılı olabiliyor; anlamlı çıkmayan çalışmalar çoğu zaman yayımlanmadığı için literatür, gerçekte olduğundan daha büyük etkiler gösterebiliyor. Meta-analiz varsa ondan yararlanmak iyi bir başlangıç; tek çalışmaya göre daha kesin bir tahmin veriyor, ama yayımlanmamış çalışmalar dışarıda kaldıysa yayın yanlılığını taşımaya devam ediyor. Bu yüzden meta-analizin huni grafiğine ve duyarlılık değerlendirmelerine de bakmak gerekiyor.
Strateji 2: pilot çalışma yapmak
Literatür yoksa ya da mevcut çalışmalar sizin popülasyonunuzdan çok farklıysa, 10-20 kişilik bir pilot grupla ölçüm yapmak mantıklı. Ancak küçük bir pilotta etki büyüklüğü çok belirsizdir; gerçekte olduğundan büyük de küçük de çıkabilir ve yalnız "umut verici" pilotların ardından çalışma yapıldığında plan sistematik olarak iyimser olur. Örneğin d = 0,5 çıkan 10'ar kişilik bir pilotta %95 güven aralığı yaklaşık −0,4 ile 1,4 arasındadır; sabit bir oranla küçültmek bu belirsizliği gidermez. Pilotun asıl işi fizibiliteyi (hasta alımı, ölçüm, veri toplama) sınamaktır. Güç analizinin dayanağı klinik olarak anlamlı en küçük fark (MCID) ya da benzer popülasyondaki literatür olmalı; pilot veri bunu desteklemek için kullanılır.
Hakem gözünde en savunulabilir gerekçe, seçilen etki büyüklüğünün klinik anlamını ve kaynağını açıkça yazmaktır.
Literatürden alınan bir değeri kullanmadan önce iki çalışmayı dört başlıkta karşılaştırmak yararlı oluyor.
| Karşılaştırma | Referans çalışmada | Sizin çalışmanızda |
|---|---|---|
| Hasta grubu | Yaş, hastalık şiddeti, bakım ortamı | Aynı özellikler örnekleminizde ne durumda? |
| Sonlanım ve ölçüm zamanı | Hangi ölçekle, hangi zaman noktasında ölçüldü? | Aynı ölçek ve aynı zaman noktası mı? |
| Tasarım | Randomize mi, gözlemsel mi; bağımsız gruplar mı, tekrarlı ölçüm mü? | Tasarımınız aynı mı? |
| Etki ölçüsü | Ortalama farkı mı, oran mı, odds oranı mı? | Güç analizinde kullanılacak ölçüye dönüştürülebilir mi? |
Bu satırlardan birinde belirgin bir fark varsa sayıyı olduğu gibi almak yerine gerekçeli bir aralıkla çalışmak daha doğru olur. Kaynaktan gelen etki varsayımının çalışmanıza uyup uymadığını güç analizi sürecinde birlikte değerlendiriyoruz.
Strateji 3: Cohen referans değerleri
Hiçbir kaynak yoksa Jacob Cohen'in (1988) önerdiği genel kılavuz değerlere başvurulabiliyor: Cohen's d için küçük etki 0,2, orta etki 0,5, büyük etki 0,8.
Etki büyüklüğü kaynakları: güvenilirlik karşılaştırması
Daha güvenilir
- ✓Meta-analizden alınan ortalama etki büyüklüğü
- ✓Benzer popülasyondaki tek çalışmadan hesaplama
- ✓MCID temelli hesaplama
- ✓Kendi pilot çalışmanız (fizibilite için; etki tahmini yalnız destekleyici)
Daha az güvenilir
- ⚠Cohen genel değerleri (0,2 · 0,5 · 0,8)
- ⚠Farklı popülasyondaki çalışmadan aktarma
- ⚠Örneklem küçük olsun diye büyük değer yazma
- ⚠Gerekçesiz 'orta etki bekliyoruz' ifadesi
Bu değerler her alanda aynı anlama gelmiyor; bir etkinin büyük mü küçük mü olduğuna, onu alandaki benzer etkilerle karşılaştırarak ve pratik sonucunu gözeterek karar vermek daha doğru (Lakens 2013). Cohen'in kendisi de bu eşiklerin ancak daha iyi bir dayanak yoksa kullanılmasını önermişti. Bu yolu tercih ediyorsanız gerekçesini yöntem bölümünde açıkça belirtmeniz ve bir sınırlılık olarak not etmeniz bekleniyor.
Strateji 4: MCID (klinik olarak anlamlı en küçük fark)
Klinik çalışmalarda çoğu zaman en mantıklı yaklaşım bu. Temel soru, ne kadarlık bir farkın klinik olarak anlamlı olduğu. Sistolik kan basıncında 2 mmHg'lık düşüş mü yoksa 10 mmHg mı anlamlı? Yanıt 10 mmHg ise ve genel popülasyonda standart sapma yaklaşık 15 mmHg ise, buradan d = 10 / 15 = 0,67 elde edilir.
Bu yaklaşım hem istatistiksel hem de klinik olarak anlamlı bir zemin kuruyor ve hakeme çok net bir gerekçe veriyor: "Klinik olarak anlamlı en küçük fark X birim kabul edilmiş, popülasyon standart sapması Y alınmıştır." Yaygın ölçeklerin (örneğin VAS ağrı skoru, SF-36, WOMAC) MCID değerleri literatürde tanımlı olduğu için bunları kullanmak etki büyüklüğü belirlemesini çok daha sağlam kılıyor.
Dört stratejiyi bir arada görmek, hangi durumda hangisine başvurulacağını netleştiriyor:
| Strateji | Kaynak | Güçlü yanı | Dikkat |
|---|---|---|---|
| Literatür / meta-analiz | Yayımlanmış çalışmalar | En sağlam gerekçe | Yayın yanlılığı abartabilir |
| Pilot çalışma | Kendi ön veriniz | Popülasyona özgü ama belirsizliği yüksek | Tek başına dayanak olmaz; MCID ya da literatürle birlikte kullanılır |
| MCID | Klinik anlamlı en küçük fark | Klinik ve istatistik anlam | Ölçeğe özgü MCID gerekir |
| Cohen varsayılanları | 0,2 / 0,5 / 0,8 | Kaynak yokken pratik | Son çare; yöntemde gerekçelendir |
Hangi metrik hangi analize?
Etki büyüklüğü tek bir formül değil; analiz tipine göre farklı metrikler kullanılıyor. İki grup karşılaştırmasında (sürekli değişken) Cohen's d, kategorik değişkenlerde odds ratio veya risk ratio, korelasyon analizinde Pearson r, ANOVA'da Cohen's f, regresyonda f² veya R² devrede. G*Power'da doğru metriği seçmek belirleyici; yanlış metrik seçildiğinde hesaplama temelden hatalı oluyor. Her metriğin ayrıntısını ve dönüşüm formüllerini etki büyüklüğü hesaplama yöntemleri yazımızda ele aldık.
Etki büyüklüğü çok küçük çıkarsa?
Diyelim ki literatürden hesapladınız ve d = 0,15 çıktı. Bu durumda G*Power'ın istediği örneklem, iki grup için yaklaşık 1400 kişiye (grup başına ~700) ulaşıyor; bu, tek bir merkezin toplaması zor bir sayı. Etki küçüldükçe gereken örneklemin ne kadar hızlı büyüdüğünü aşağıdaki eğri gösteriyor:
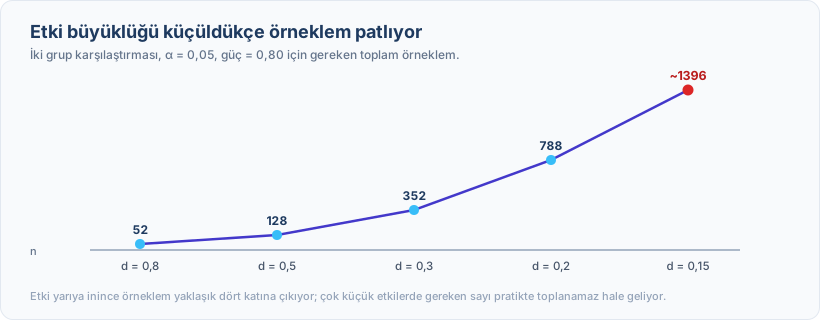
Böyle bir durumda üç seçenek var. Birincisi, çalışmayı bu hâliyle yürütmemek; etki gerçekten çok küçük ve örneklem toplanamayacaksa çalışma zaten baştan yetersiz güçte olur. İkincisi, farklı bir sonlanım noktası seçmek; belki daha büyük etkiye sahip, klinik olarak da değerli bir ölçüt vardır. Üçüncüsü, çalışmayı keşfedici (exploratory) olarak sunmak; ama bu durumda yetersiz güç sınırlılığının açıkça raporlanması şart. Küçük örneklemle geçerli çıktı üretmenin yollarını nadir hastalıklarda örneklem yazımızda ayrıca ele aldık.
Etki büyüklüğünü abartmak
Danışanlarımızda sık gördüğümüz bir durum, araştırmacının bilerek büyük bir etki büyüklüğü girmesi, örneğin 0,3 yerine 0,8. Amaç genellikle daha az hasta toplamak. Oysa bu, güç analizini içeriden zayıflatıyor. Hakem "etki büyüklüğü 0,8, makul" diyerek onaylayabilir; ama gerçek etki 0,3 ise çalışma yetersiz güçte kalıyor, p > 0,05 çıkma olasılığı yükseliyor ve aylar süren veri toplama anlamsız bir sonuçla bitiyor.
10 yıllık gözlemimize göre araştırmacıların önemli bir bölümü etki büyüklüğünü literatür taraması ya da pilot veri olmadan, yalnızca "makul görünen" bir sayı olarak belirliyor. Sonuç çoğu zaman aynı; çalışma bitiyor, p > 0,05 çıkıyor ve "örneklem yetersizdi" deniyor. Gerçekten de yetersizdi, çünkü etki büyüklüğü baştan yanlış seçilmişti.
Uyarı
Gözlenen etki büyüklüğünü güven aralığıyla birlikte raporlamak gerekir; CONSORT 2025 de bunu istiyor. Hata, bu gözlenen değerle çalışma bittikten sonra güç hesaplamaktır (post hoc güç); böyle bir güç p değerinin başka bir biçimidir ve yeni bilgi vermez. Güç analizi çalışmadan önce yapılır. Bu konuyu post-hoc güç analizi yazımızda ele aldık.
Şeffaflık: en güçlü savunma
Etki büyüklüğünü belirlerken kaynağını açıkça belirtmek, güç analizinin en güçlü savunması. Örneğin: "Örneklem büyüklüğü, benzer popülasyonda yürütülen bir referans çalışmada bildirilen etki büyüklüğü (Cohen's d = 0,55) temel alınarak hesaplanmıştır." Ya da: "Klinik olarak anlamlı en küçük fark 5 puan kabul edilmiş, popülasyon standart sapması 10 alınmıştır (d = 0,5)." Böylece hakem varsayımınızı değerlendirebiliyor; şeffaflık, güvenilirliğin ve savunulabilirliğin temeli oluyor.
Temel kavramları güç analizi nedir yazımızda, pratik hesaplamaları örneklem büyüklüğü hesaplama yazımızda ele almıştık. Model İstatistik olarak güç analizi sürecinde etki büyüklüğü belirleme adımını (literatür taraması, pilot veri değerlendirmesi ve MCID hesaplaması) standart olarak dâhil ediyoruz ve araştırmacıyla birlikte en savunulabilir gerekçeyi kuruyoruz. Etki büyüklüğü güç analizinin temeli; bu temel sağlam olduğunda hesabın geri kalanı da savunulabilir hâle geliyor.
Not: Buradaki örneklem değerleri iki yönlü test için tipik G*Power çıktılarıdır ve testin tam yapılandırmasına göre az miktarda değişebilir. Kesin planlama, çalışmanın kendi tasarımı üzerinden yapılır.
Kullanılan kaynaklar
- Cohen J. Statistical Power Analysis for the Behavioral Sciences. 2. baskı. Hillsdale, NJ: Lawrence Erlbaum; 1988.
- Lakens D. Calculating and reporting effect sizes to facilitate cumulative science: a practical primer for t-tests and ANOVAs. Frontiers in Psychology. 2013;4:863. · DOI
- Sullivan GM, Feinn R. Using effect size—or why the P value is not enough. Journal of Graduate Medical Education. 2012;4(3):279-282. · DOI
- Hopewell S, Chan AW, Collins GS, ve ark. CONSORT 2025 statement: updated guideline for reporting randomised trials. BMJ. 2025;389:e081123. · PMID: 40228833